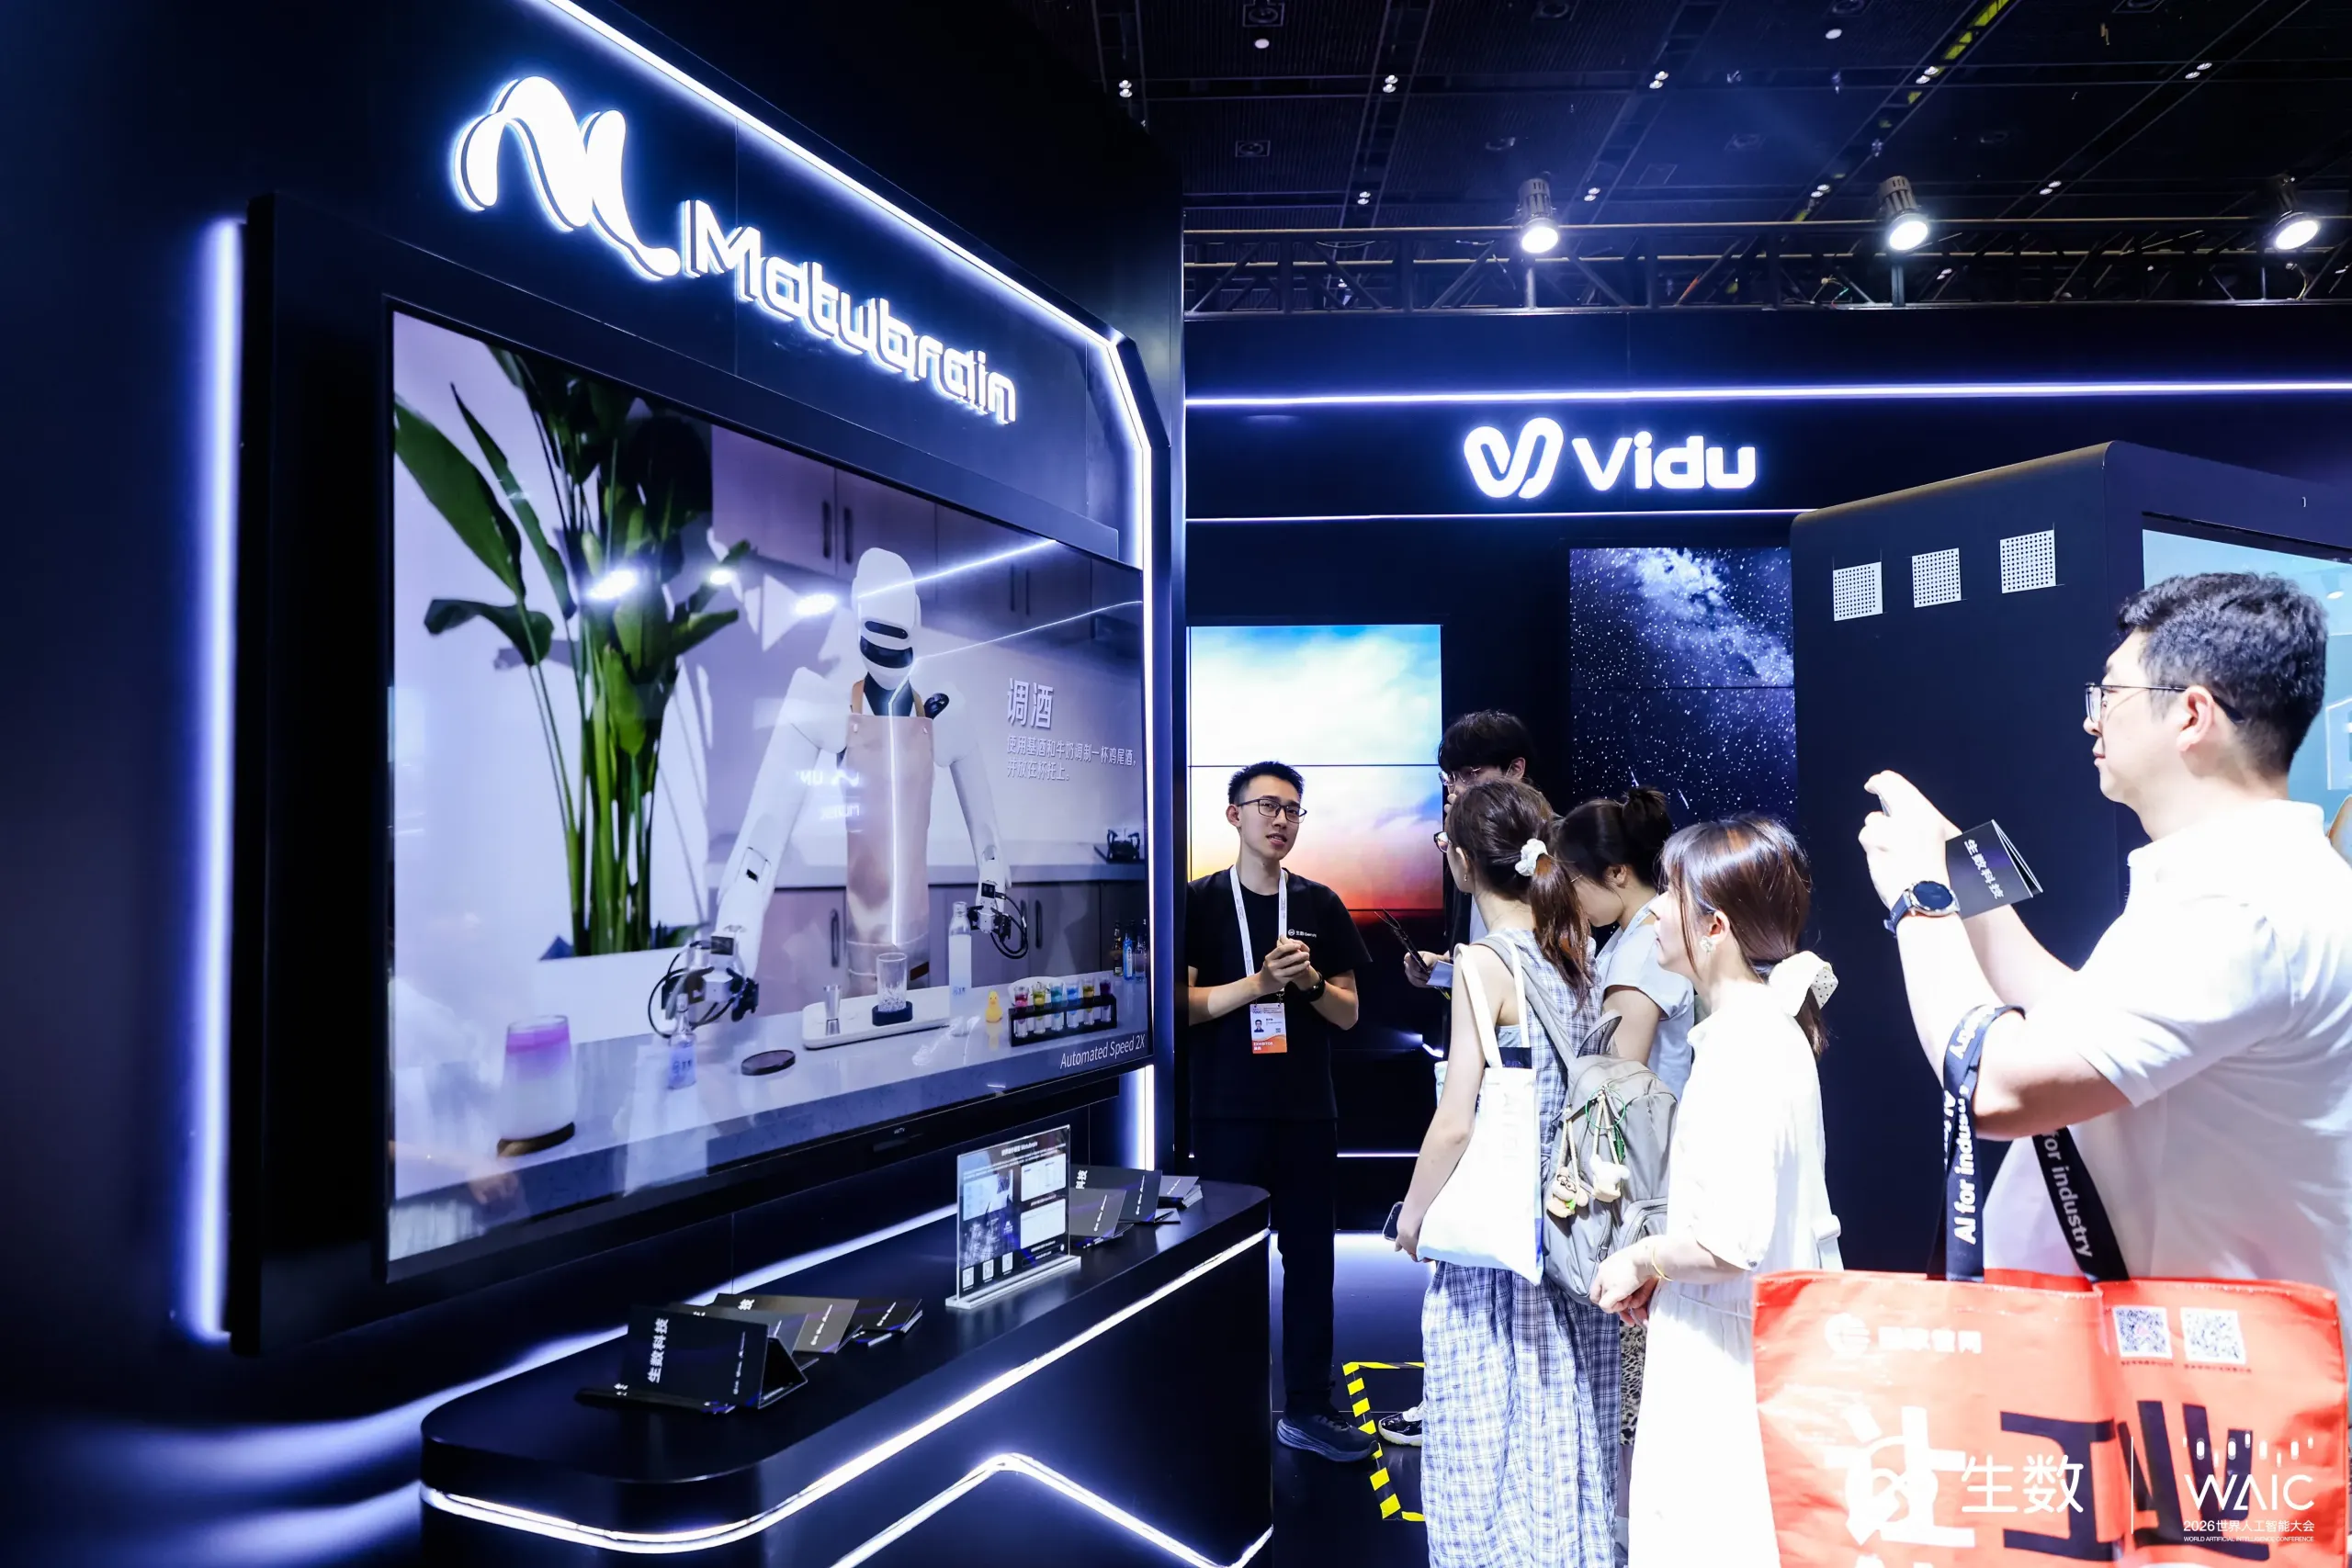
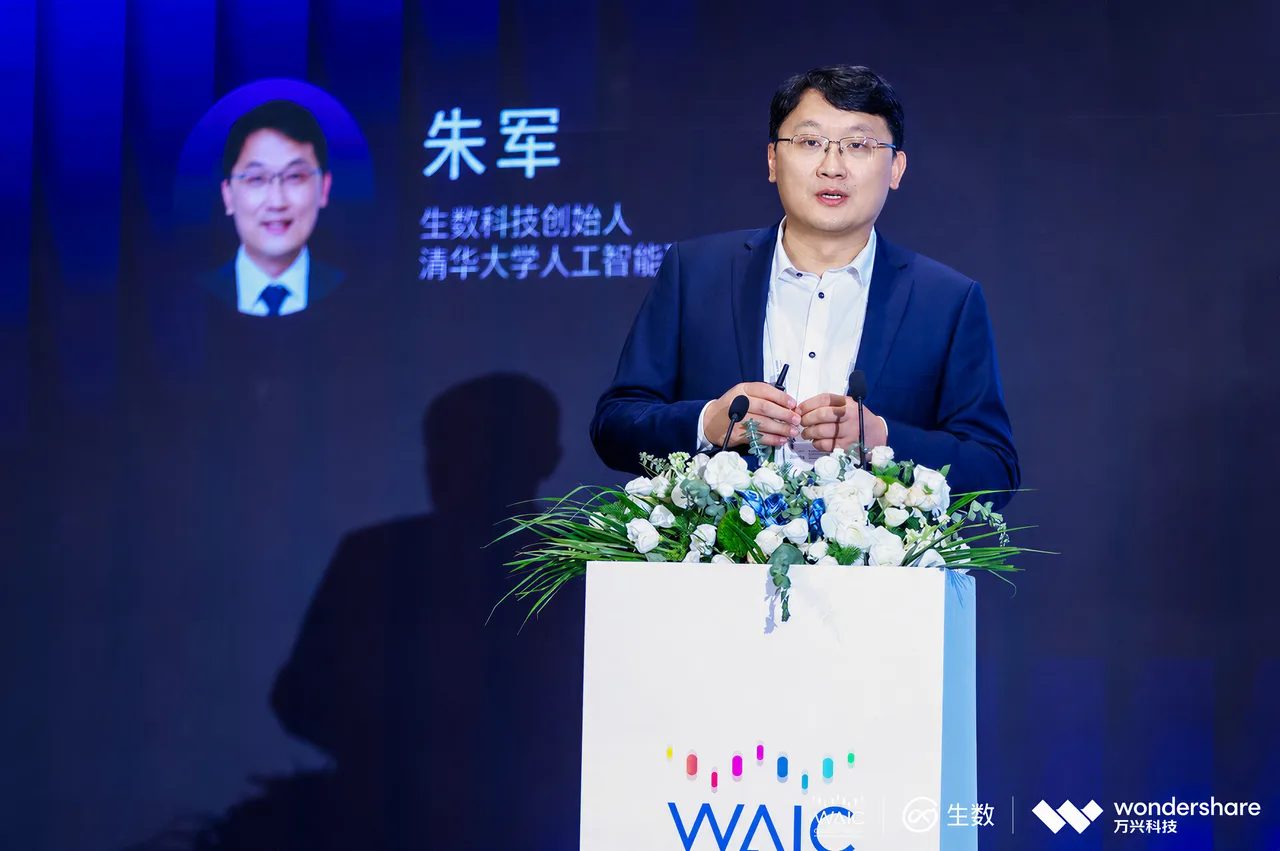
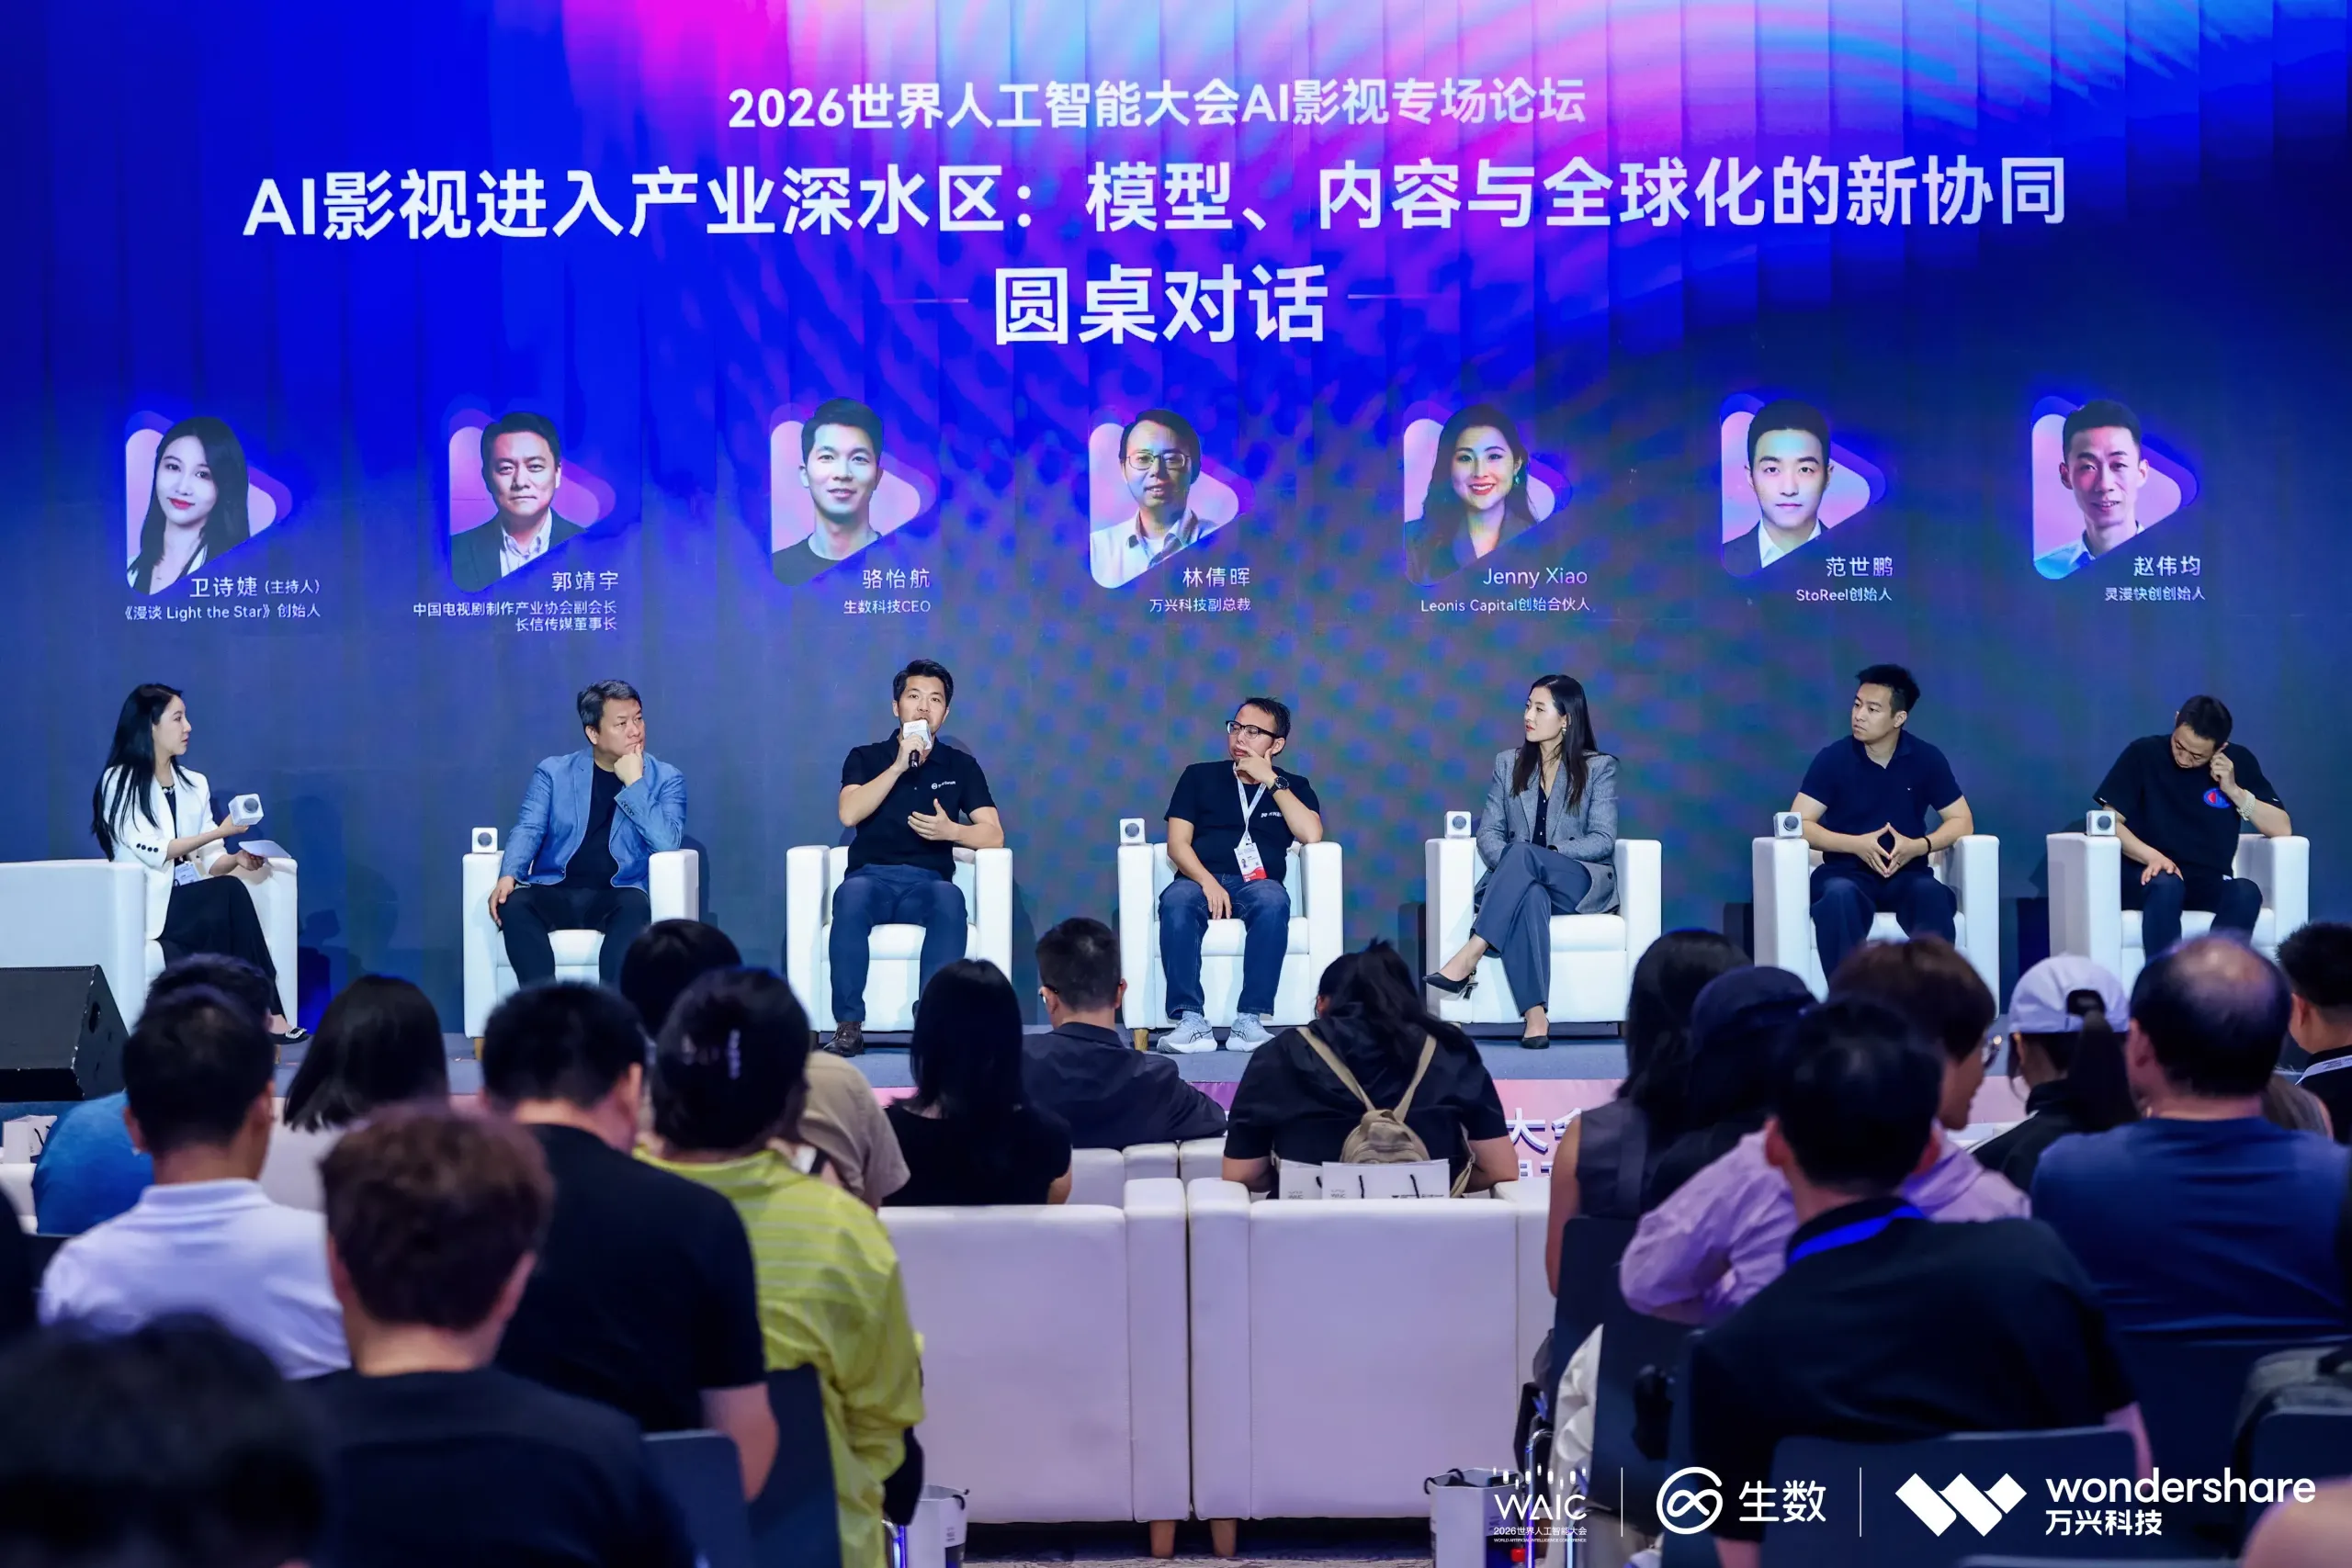
论坛之外,生数科技的通用世界模型技术及产品也在 WAIC 展区集中亮相。以通用世界模型为底座,生数科技持续打造连接数字世界与物理世界的桥梁。
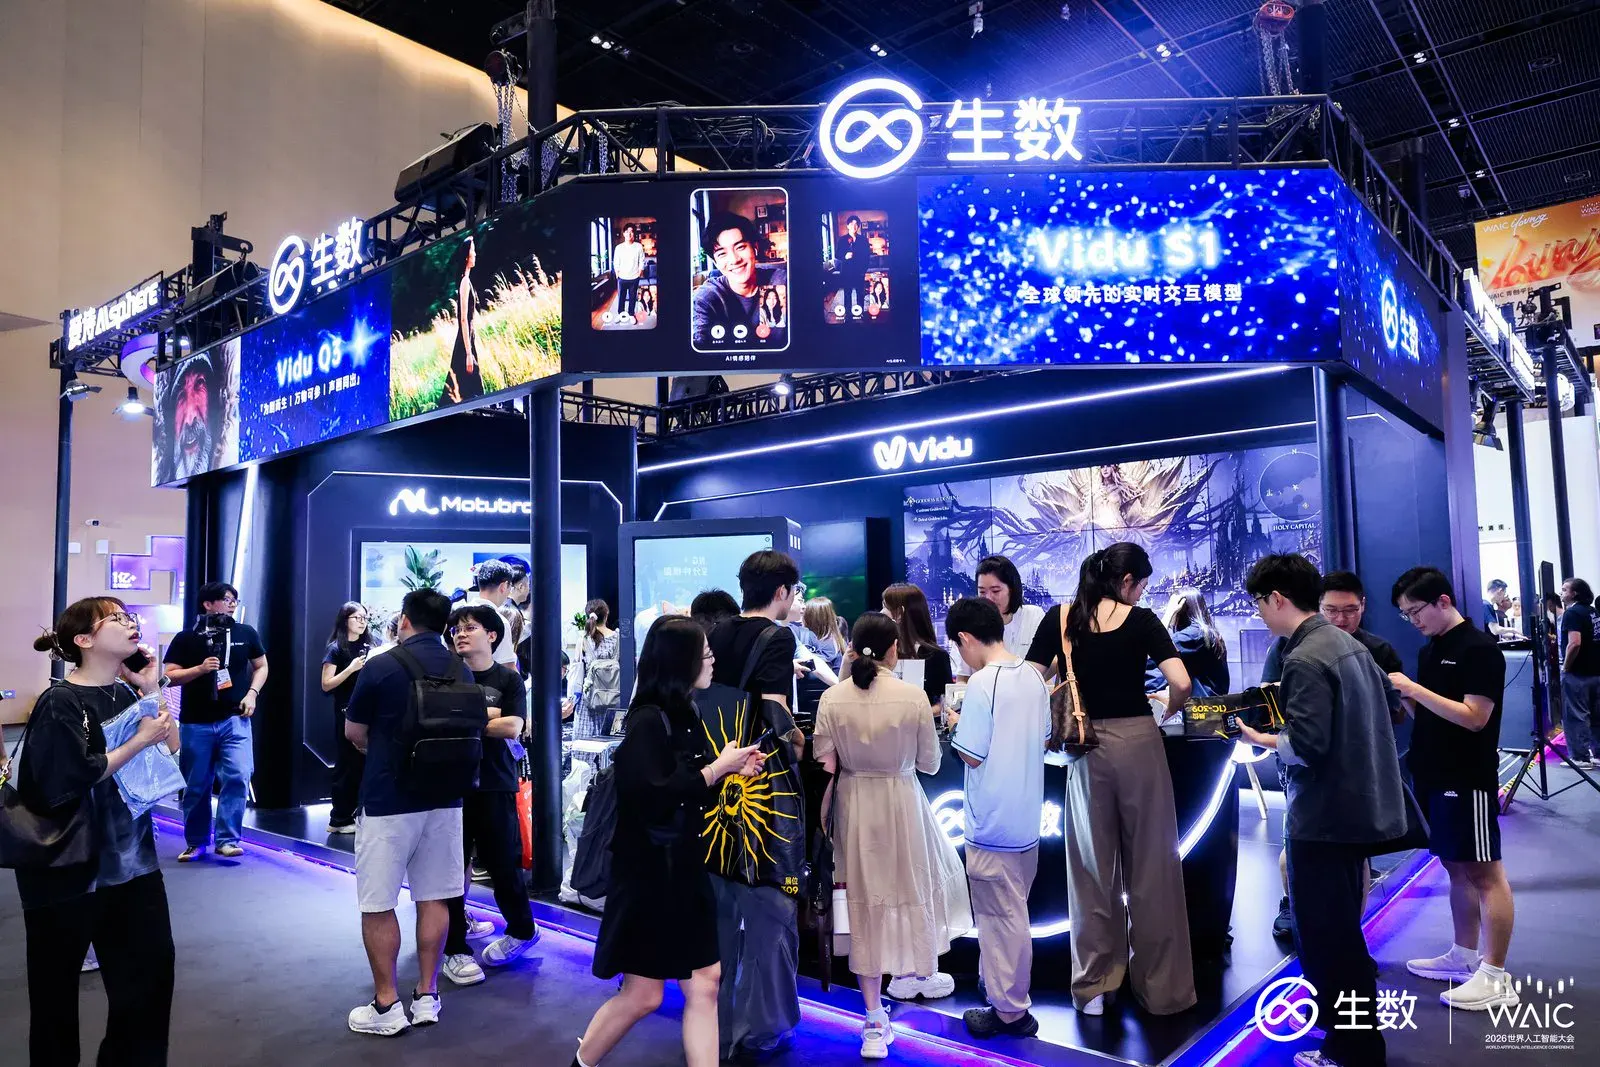
在数字世界,Vidu 支持文生视频、图生视频、参考生视频等创作方式,持续提升内容生成的一致性、物理合理性与交互性;Vidu S1 进一步推动视频生成从离线内容走向实时互动。
在物理世界,世界动作模型 Motubrain 以一个通用大脑驱动多种机器人理解、预测并行动于世界,推动通用世界模型从“视觉推演”迈向“物理决策”。
展区现场,参会者通过 Vidu Q3、Vidu S1 和 Motubrain 等技术及产品演示,直观体验了世界模型在内容生产、实时互动及具身智能等场景中的应用。
世界生成模型 Vidu
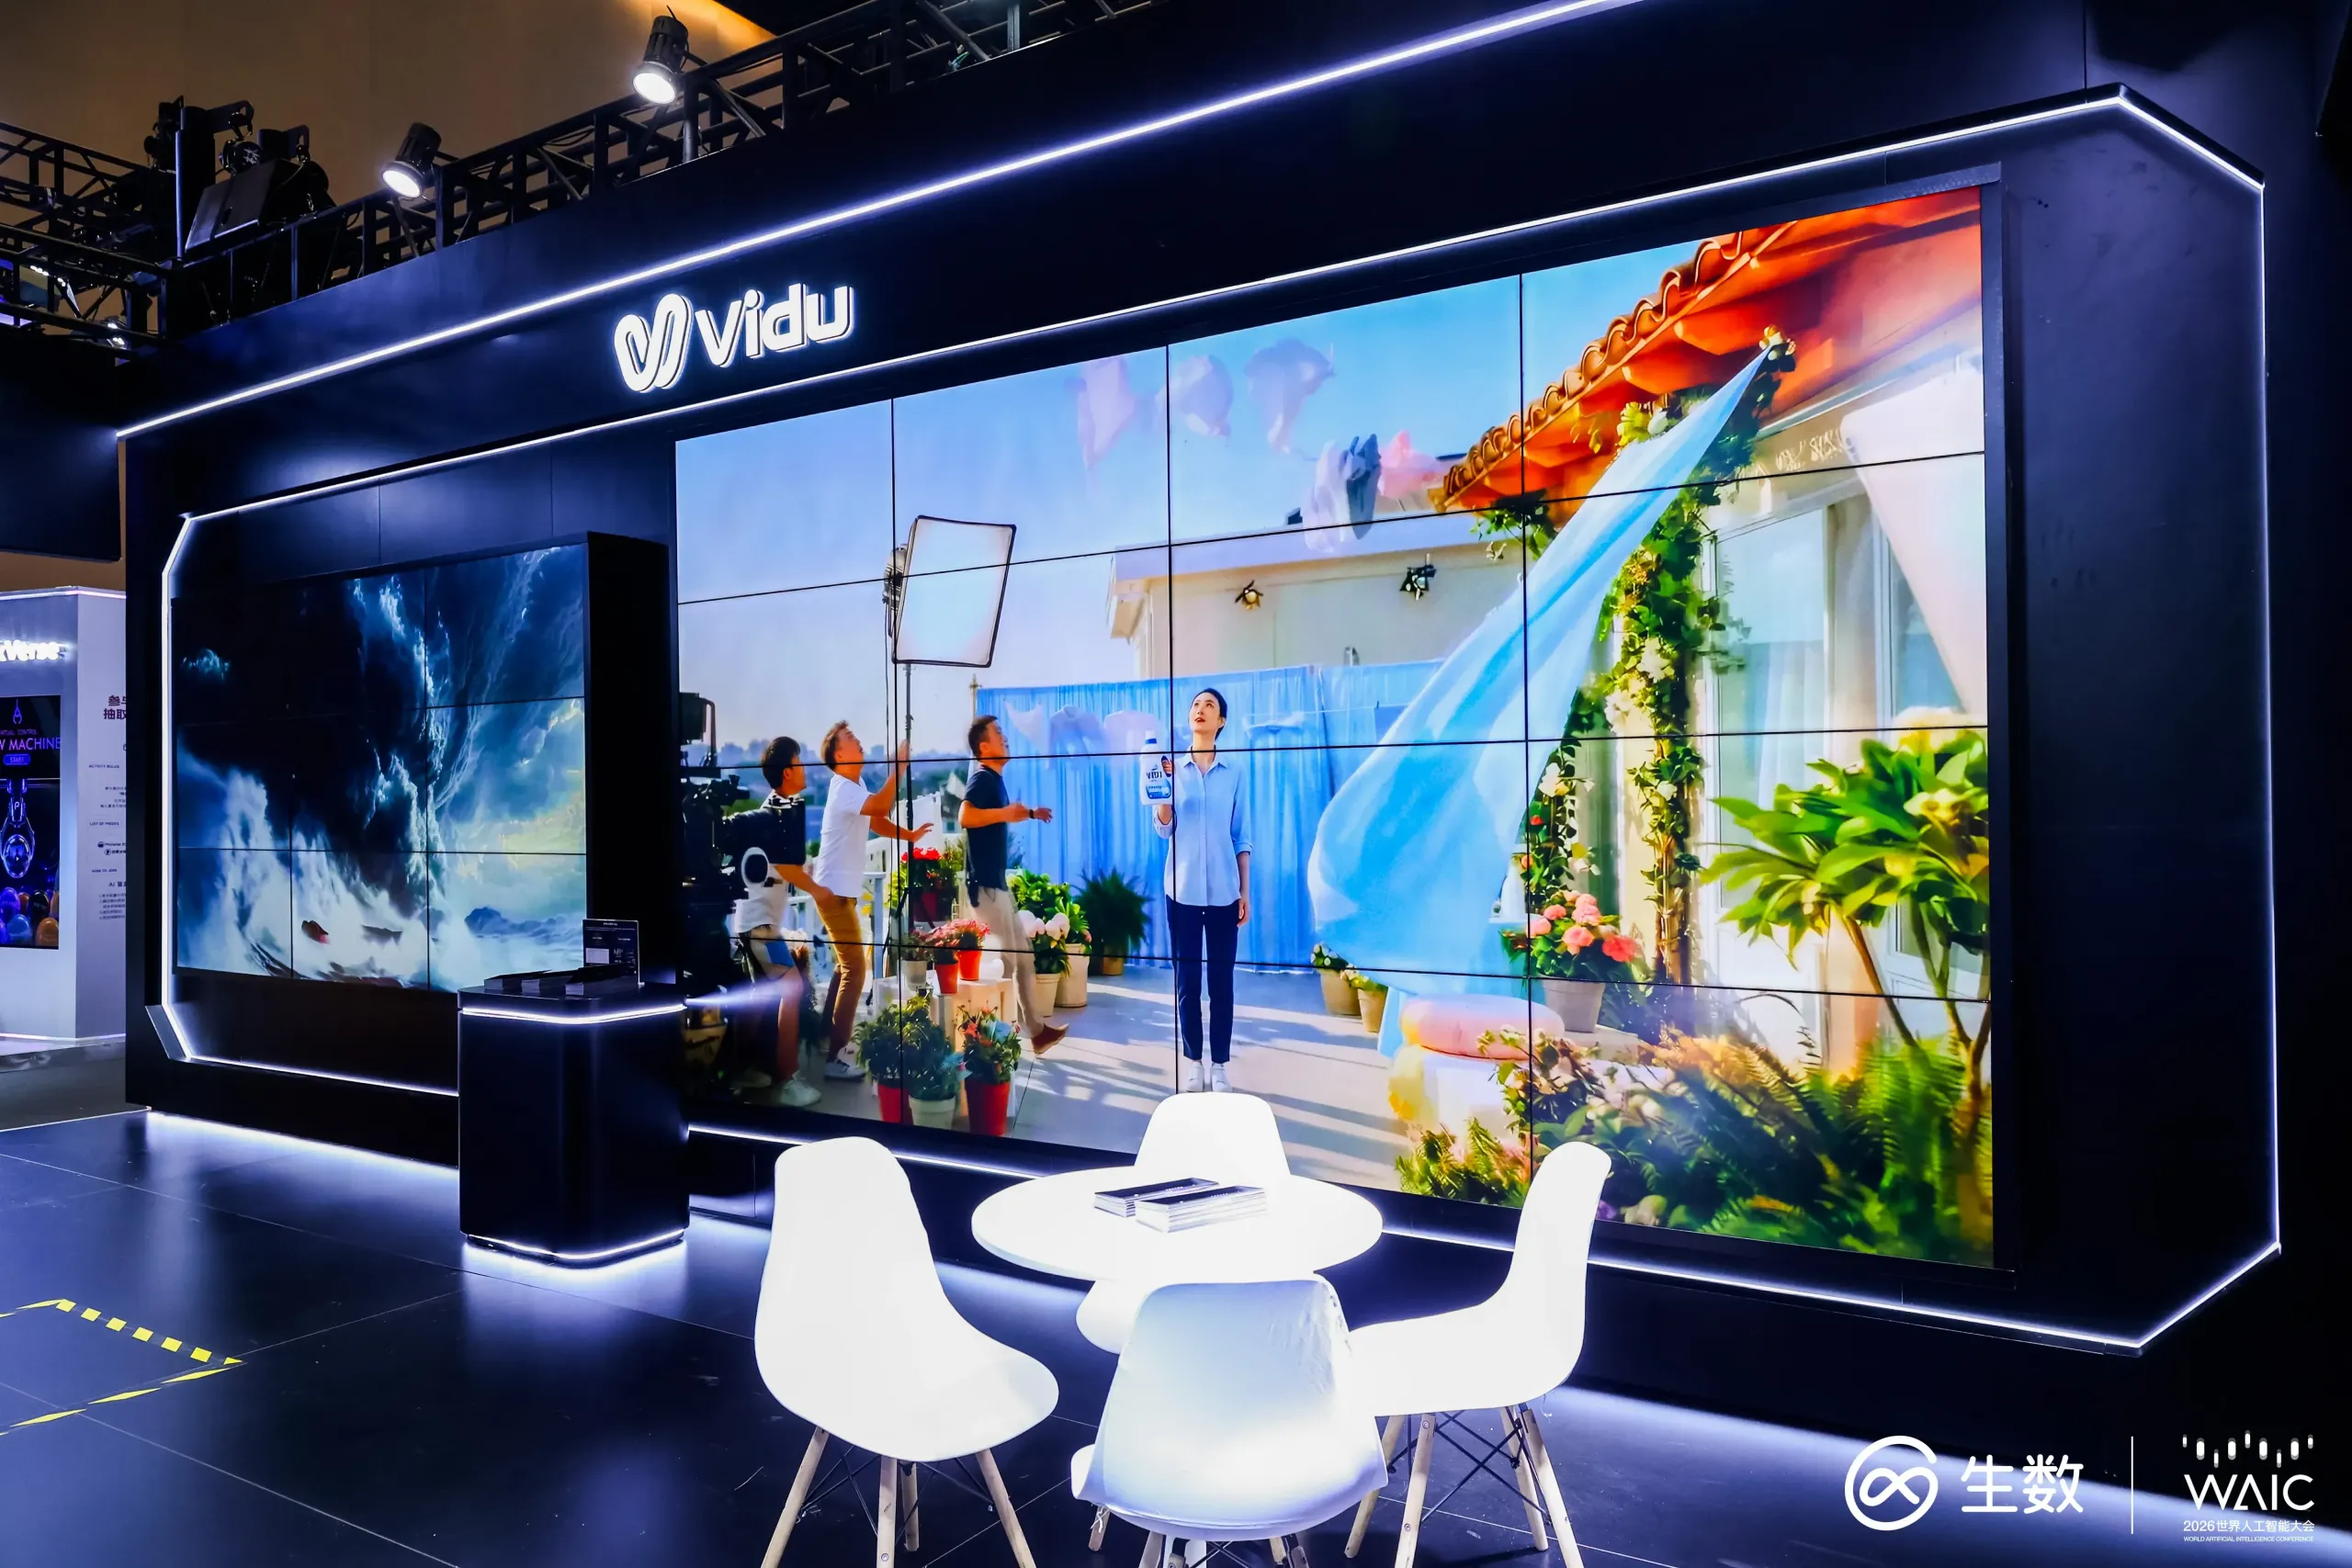
作为生数科技面向数字世界打造的世界生成模型,Vidu 依托基座世界模型对人物、物体、场景、运动及视听信息的理解与重构能力,为创作者和企业提供多模态内容生成能力。
Vidu 支持文生视频、图生视频、参考生视频等创作方式,持续提升主体与场景一致性、运动表现、物理合理性、镜头控制及内容交互性,帮助创作者更加高效地完成高保真内容创作。
不同于仅生成单段画面,Vidu 进一步探索内容背后人物关系、空间结构、动态变化和物理规律的建模与推演,推动模型从“生成数字内容”走向“理解世界规律并构建动态数字世界”。
目前,Vidu 已形成覆盖 SaaS、MaaS API、Agent 等形态的产品与服务矩阵,持续服务广告、短剧、漫剧、影视、电商等行业,推动 AI 视频从创意展示走进规模化内容生产流程。
实时交互模型 Vidu S1
如果说传统视频生成解决的是“生成一段内容”,那么 Vidu S1 进一步探索的是“生成一个能够实时回应并持续互动的数字角色”。
展台现场,用户可基于真人、动漫、萌宠等任意初始形象和个性化音色,快速创建专属交互角色,并通过语音与角色实时交流、控制视频走向。
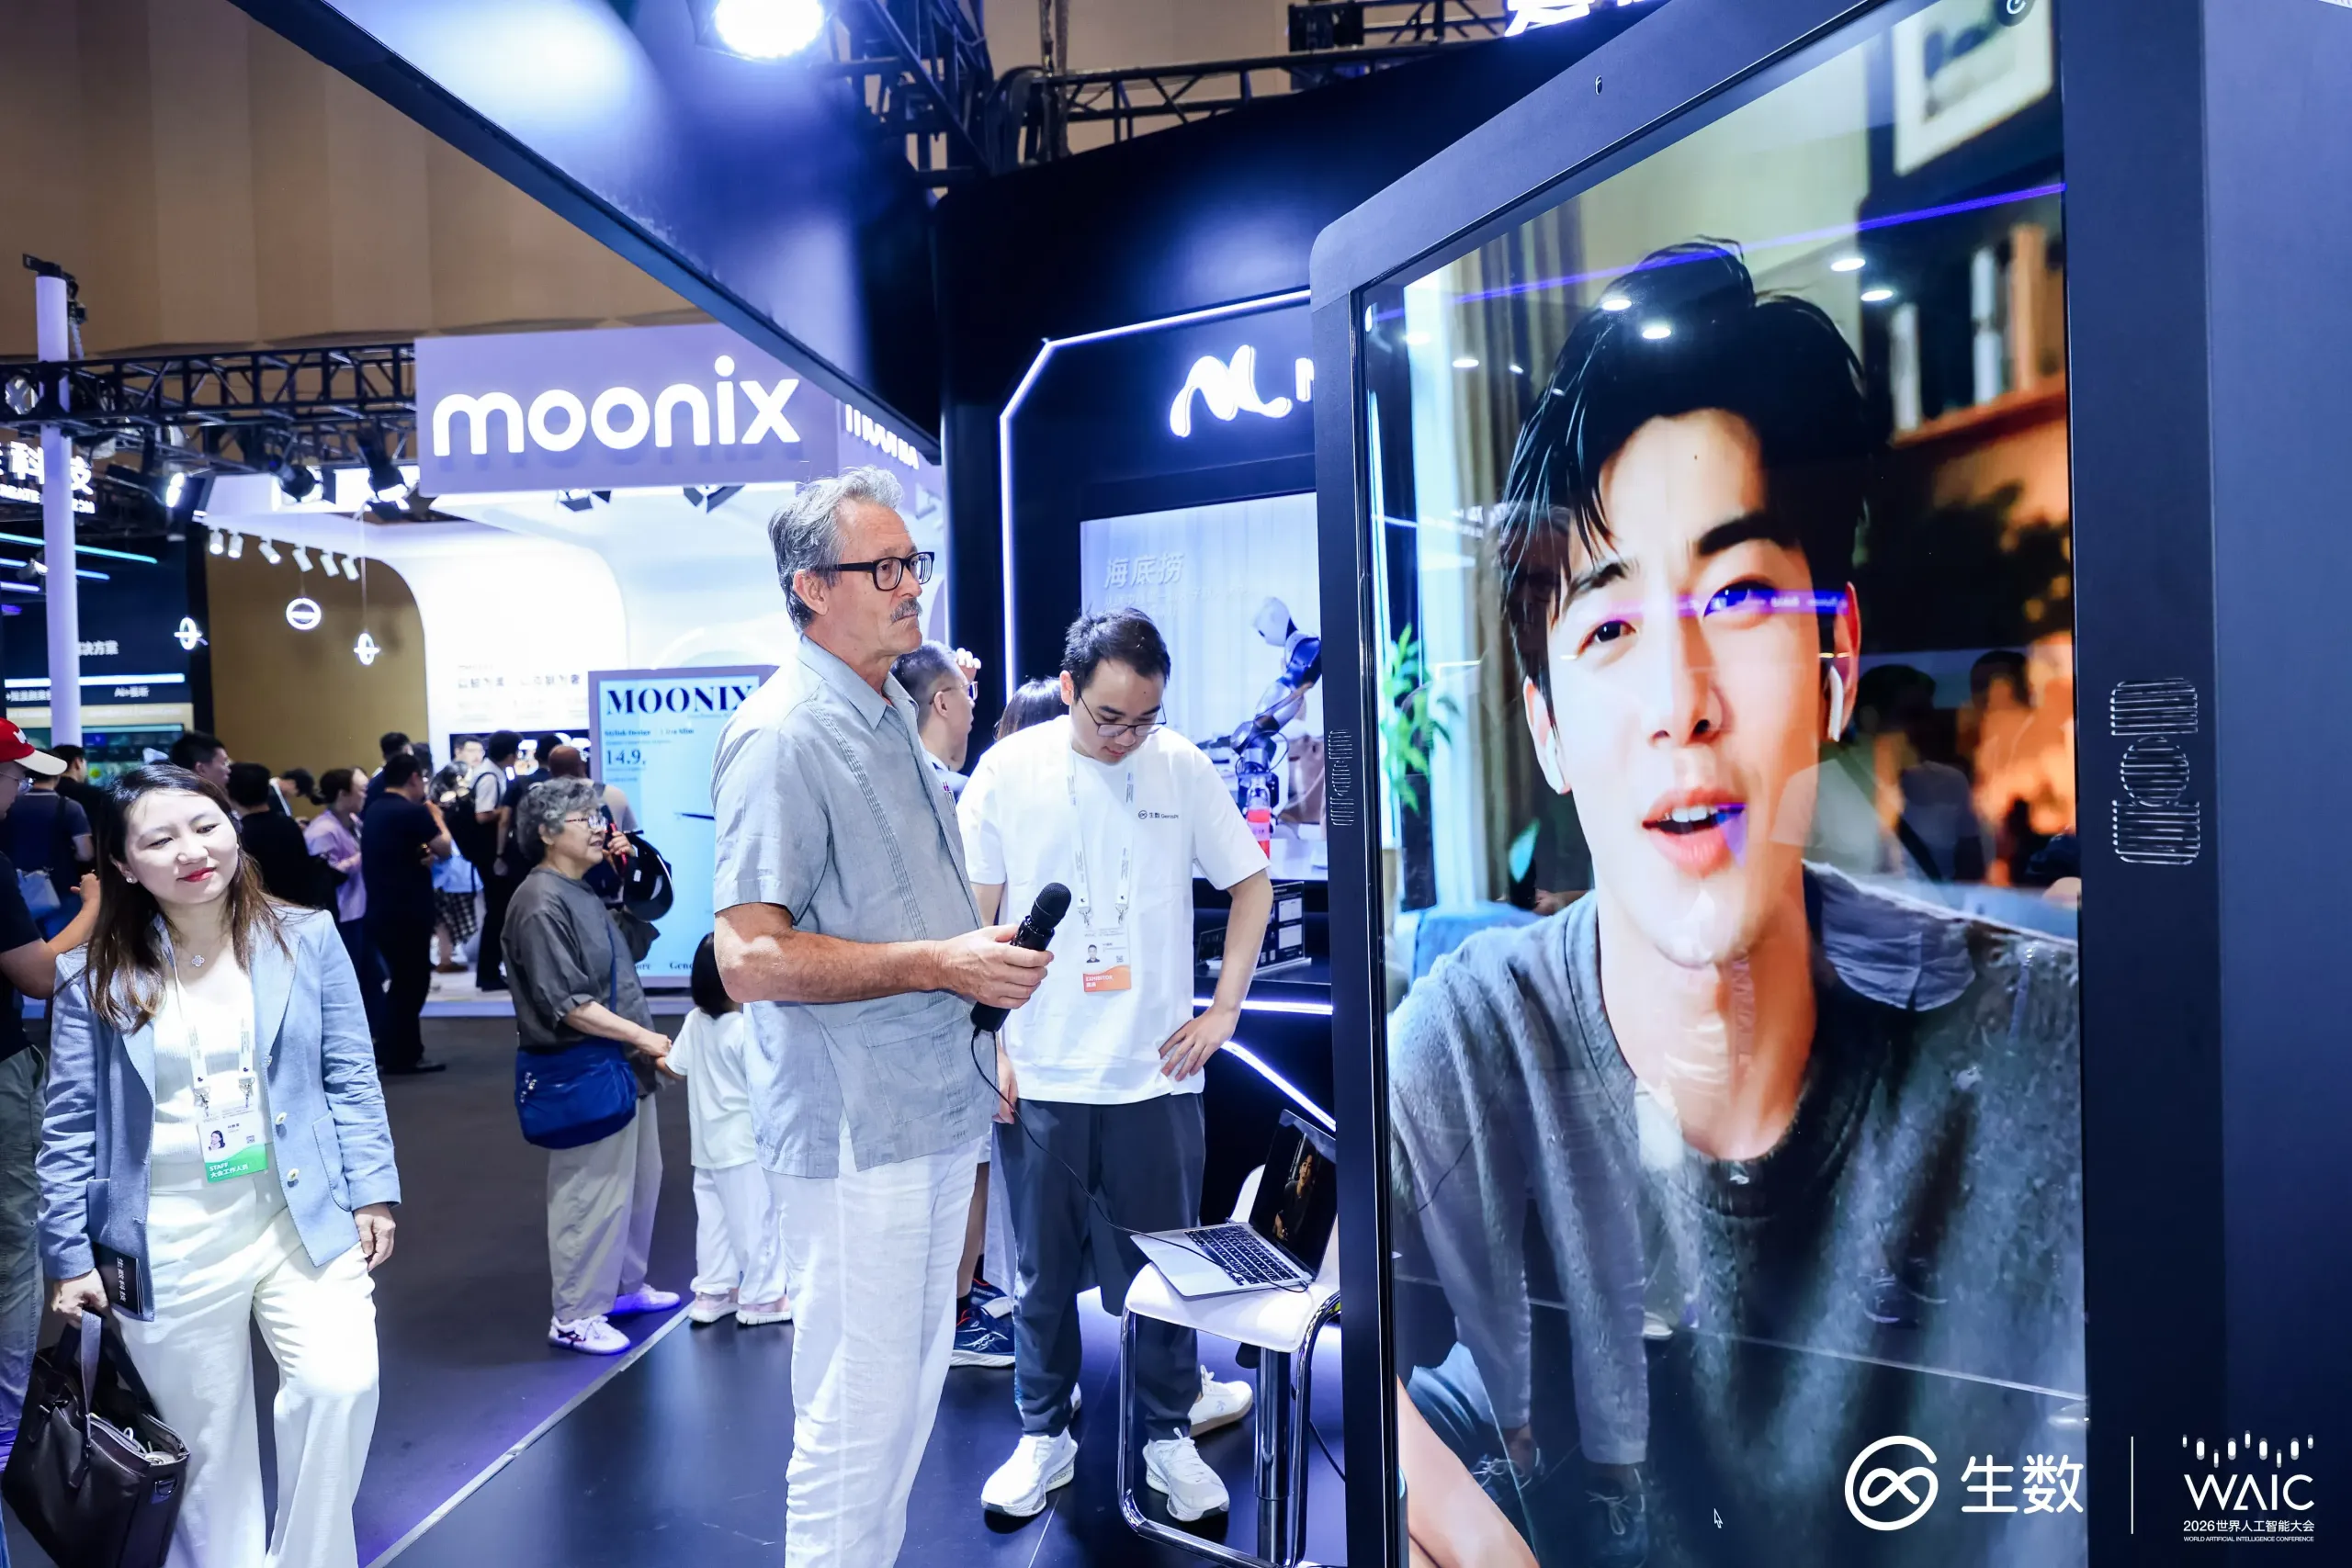
Vidu S1 能够结合语音语义、情绪、对话上下文及当前画面,实时生成角色的口型、表情、眼神、手势、身体姿态和后续动作,不再局限于简单的口型驱动或预设动作。
模型支持实时视频通话和无限时长连续互动,可实现 540P、25FPS 的视频通话级输出,最高支持 42FPS,在生成质量、响应速度与交互连续性之间实现平衡。
从生成一段固定视频,到生成一个能够实时回应、持续互动的数字角色,Vidu S1 将视频生成进一步带入实时、连续、可交互的新阶段,为 AI 情感陪伴、虚拟偶像、互动直播、游戏 NPC、品牌数字人、智能客服、在线教育及 XR 等场景提供新的技术基础。
世界动作模型 Motubrain
作为生数科技连接数字世界与物理世界的进化核心,世界动作模型 Motubrain 定位于具身智能机器人的通用大脑,以一个通用大脑驱动多种机器人理解、预测并行动于世界。
Motubrain 采用 Mixture-of-Transformer(MoT)架构,将环境理解、世界状态预测与动作轨迹生成整合至统一模型框架,减少多个模型逐级协作带来的信息割裂与误差累积,使理解、预测与行动围绕同一任务目标协同完成。
通过学习不同机器人本体、任务和场景之间可共享的世界知识,Motubrain 具备多本体适配、多任务泛化和长程任务执行能力,能够驱动不同形态的机器人在家庭、工业、商业等真实场景中,更稳定地完成连续复杂任务。
在多任务场景中,Motubrain 能够保持稳定表现,并通过共享不同任务之间的世界知识提升多任务泛化能力;在多本体场景中,一个模型能够适配多种机器人,探索打破“一个机器人一个模型”的传统模式;在长程任务中,模型能够直接学习完整任务链路,无需上层规划、任务拆解或多模型拼接;在动态环境中,模型能够理解并预测环境变化,据此持续判断、调整与行动。
在 RoboTwin 2.0 榜单中,Motubrain 在 Clean 和 Randomized 场景下分别取得95.8分和96.1分,均位列第一;在 WorldArena 榜单中,以63.77的总体EWM Score位列第一,并在运动质量、运动流畅性等多个关键维度取得领先成绩。
从理解世界、预测世界到行动于世界,Motubrain 正推动具身智能从单点能力走向通用能力、从演示验证走向真实应用。