Vidu S2:全球领先的实时交互与实时编辑模型,正式发布
过去,视频生成模型主要用于生成一段预先设定好的内容:用户输入提示词,等待模型完成计算,再获得最终视频。
Vidu S1 让 AI 视频从「离线生成」迈向「实时交互」——模型不再只生成一段固定内容,而能够在视频持续生成过程中理解用户输入、响应新的语音指令,并不断生成新的画面反馈。
今天,我们正式发布新一代模型 Vidu S2。
Vidu S2 由 Vidu S2-Avatar 实时交互模型与 Vidu S2-Editing 实时编辑模型组成,并进一步探索实时空间视频生成与编辑。S系列模型全链路研发由朱军教授的博士生、生数科技流式视频生成与推理负责人张金涛负责。
相比 Vidu S1,Vidu S2 将实时视频能力从「持续生成和交互」,进一步扩展到复杂动作、动态参考、实时编辑与空间视频。如果说 S1 解决的是“让视频实时生成、实时响应”,那么 S2 进一步回答的是:当视频正在发生时,它能否被持续理解、持续控制,并实时改变。
视频不再只是一个被生成出来的结果,而开始成为一个实时响应、持续变化的视觉世界。
为实时交互与实时编辑而生
实时视频,并不仅意味着更低的延迟。一个真正的实时交互与实时编辑模型,需要同时具备:
持续接收新的用户输入;理解当前画面与历史状态;保持角色、动作和场景长期一致;根据新的语音、图片和指令实时改变后续内容;在编辑过程中保持原视频动作、时间轴与视觉结构稳定;并在低延迟条件下持续输出高质量视频流。
为此,Vidu S2 从数据、模型架构、训练算法、推理加速到 Serving 系统进行了完整升级。
基于这一技术体系,Vidu S2 形成两条核心能力主线:
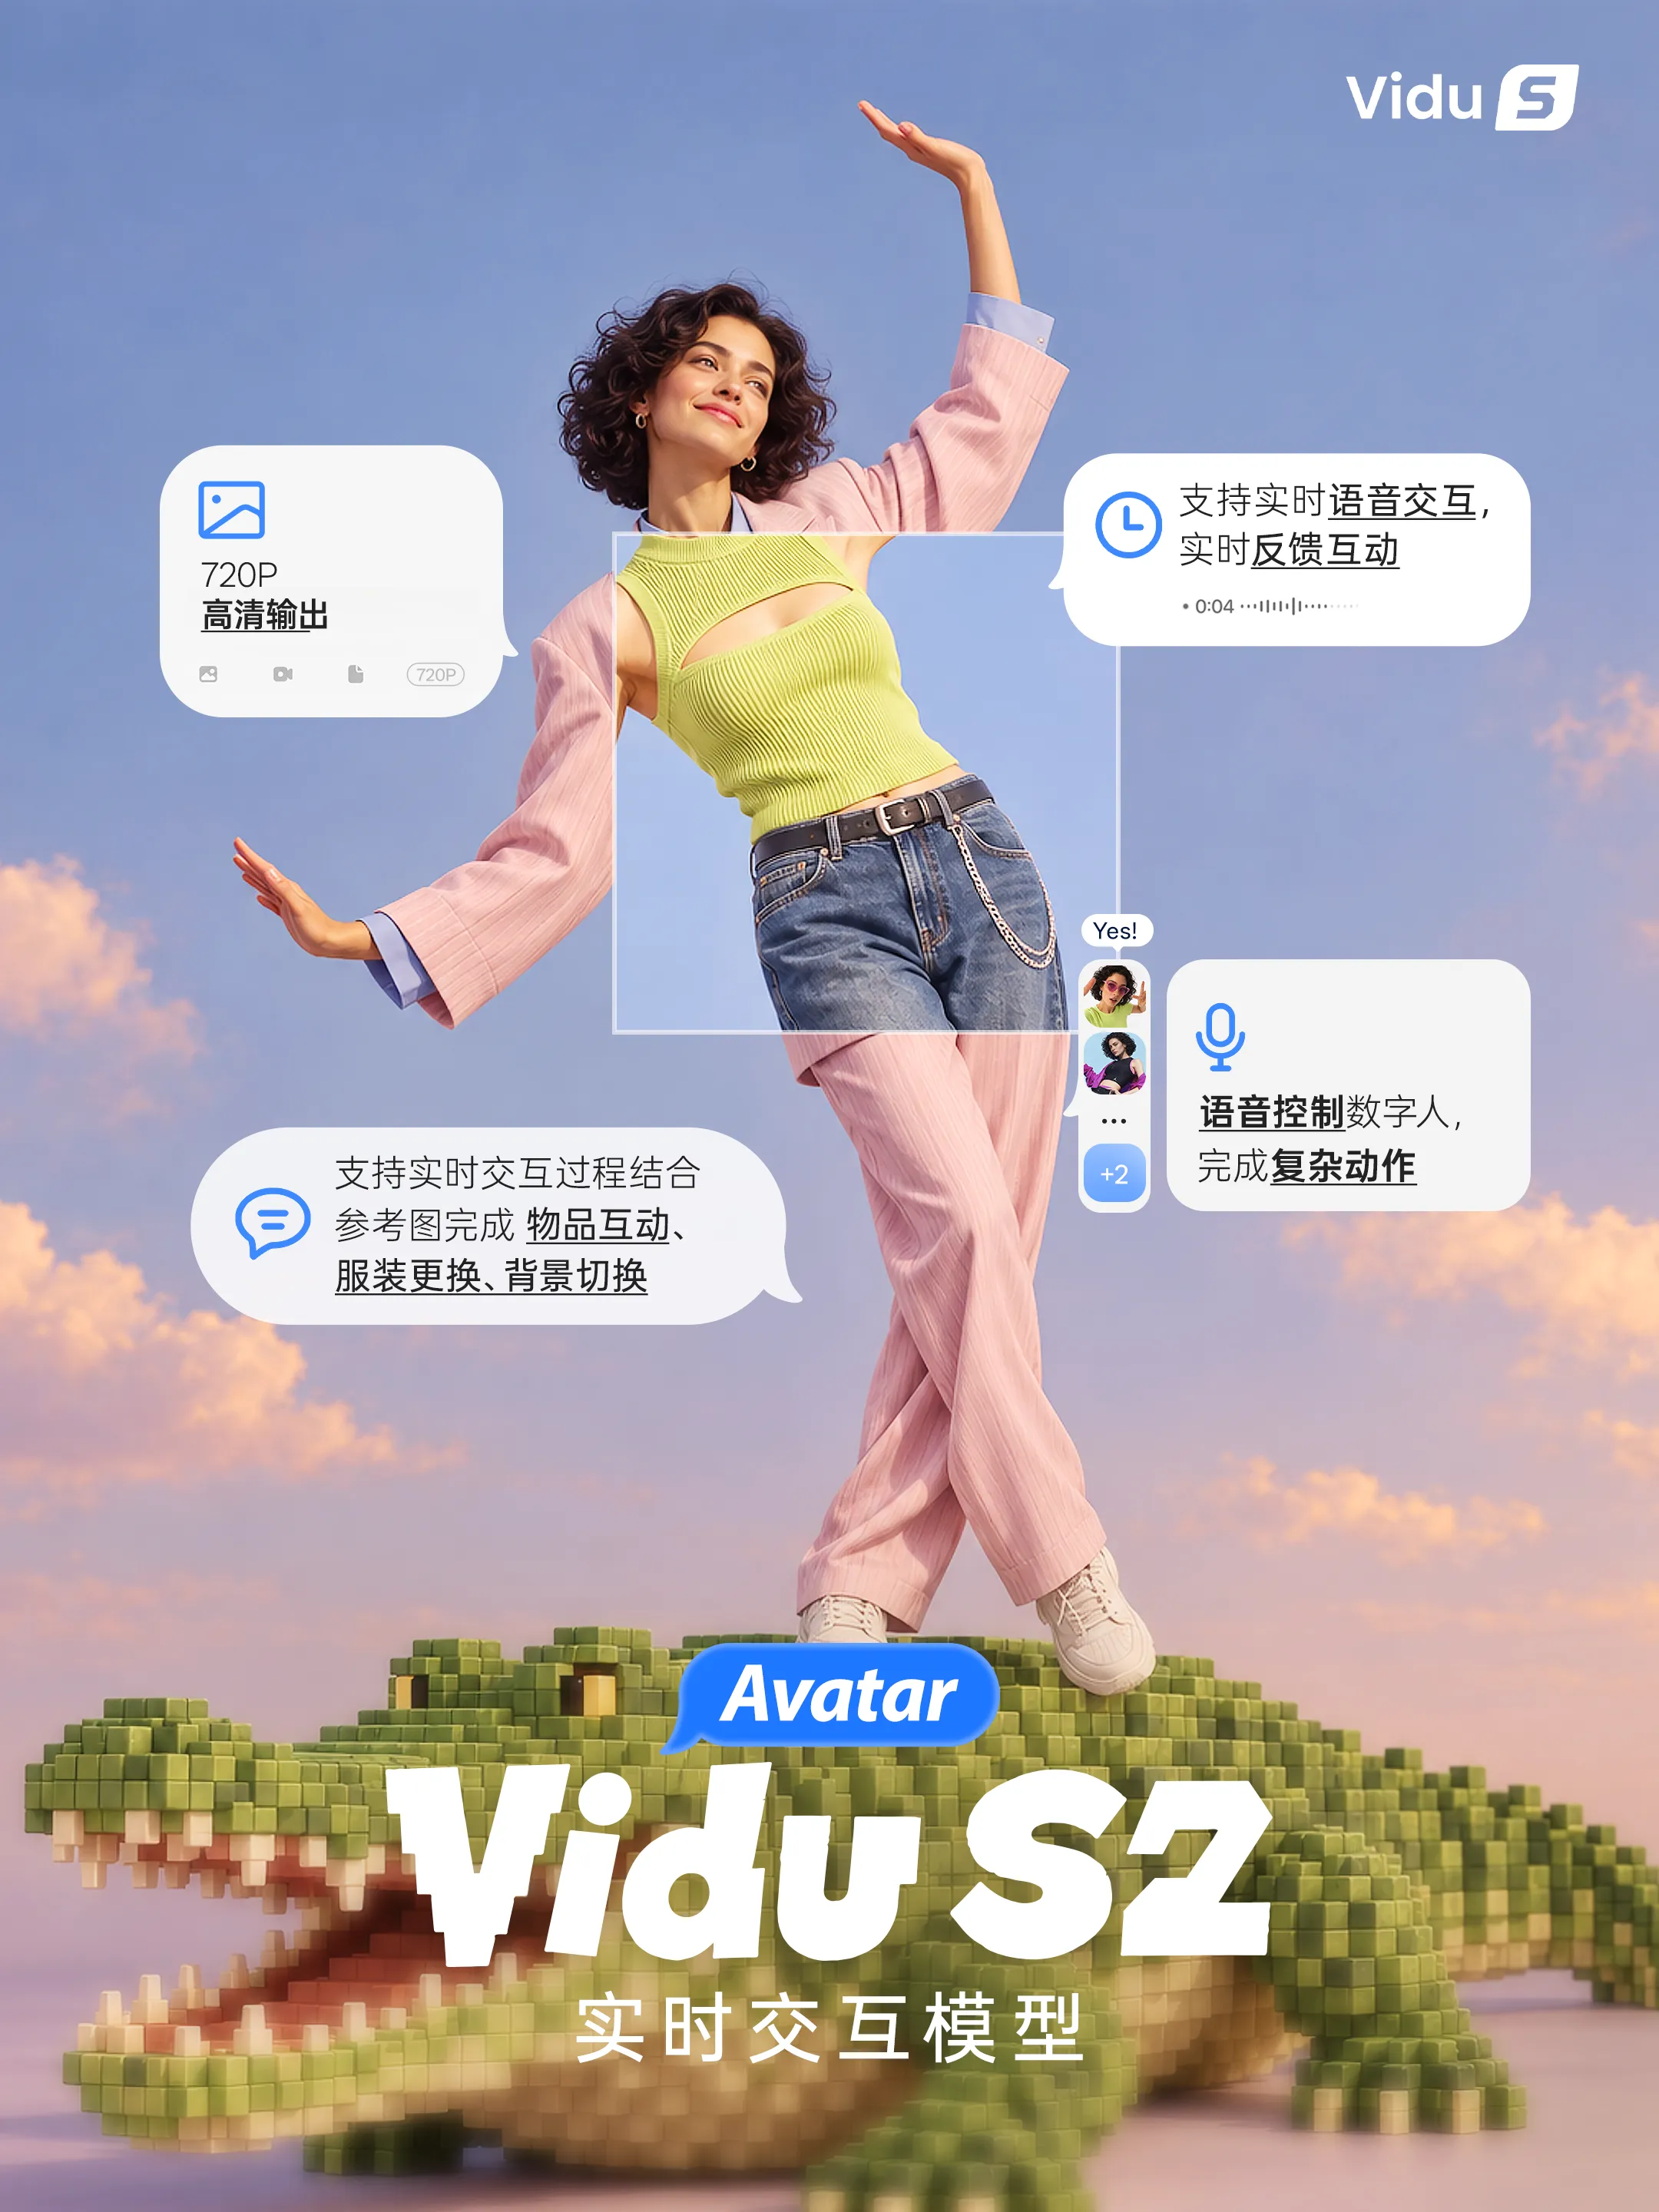
Vidu S2-Avatar:实时交互模型
- Vidu S2-Avatar:支持语音对话,语音控制数字人做复杂动作,如跳舞
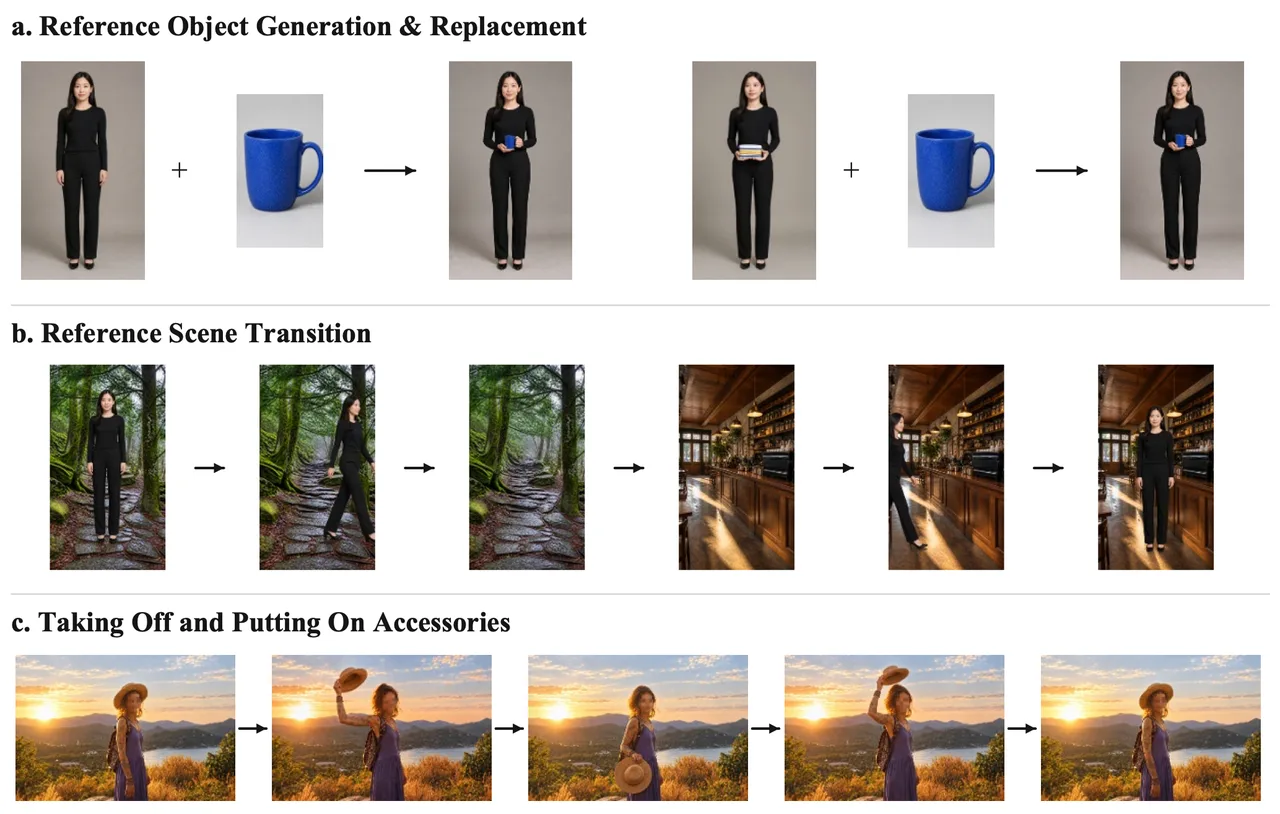
- 直播持品互动:实现根据指令与参考图中的物品互动,比如拿起来某指定物品做介绍,穿上参考图中的衣服,或将背景换成参考图中的背景
- 720P+高清画质:数字人支持720P+高清画质
- 离线数字人:高质量的离线数字人,按照预设内容读稿或者做动作
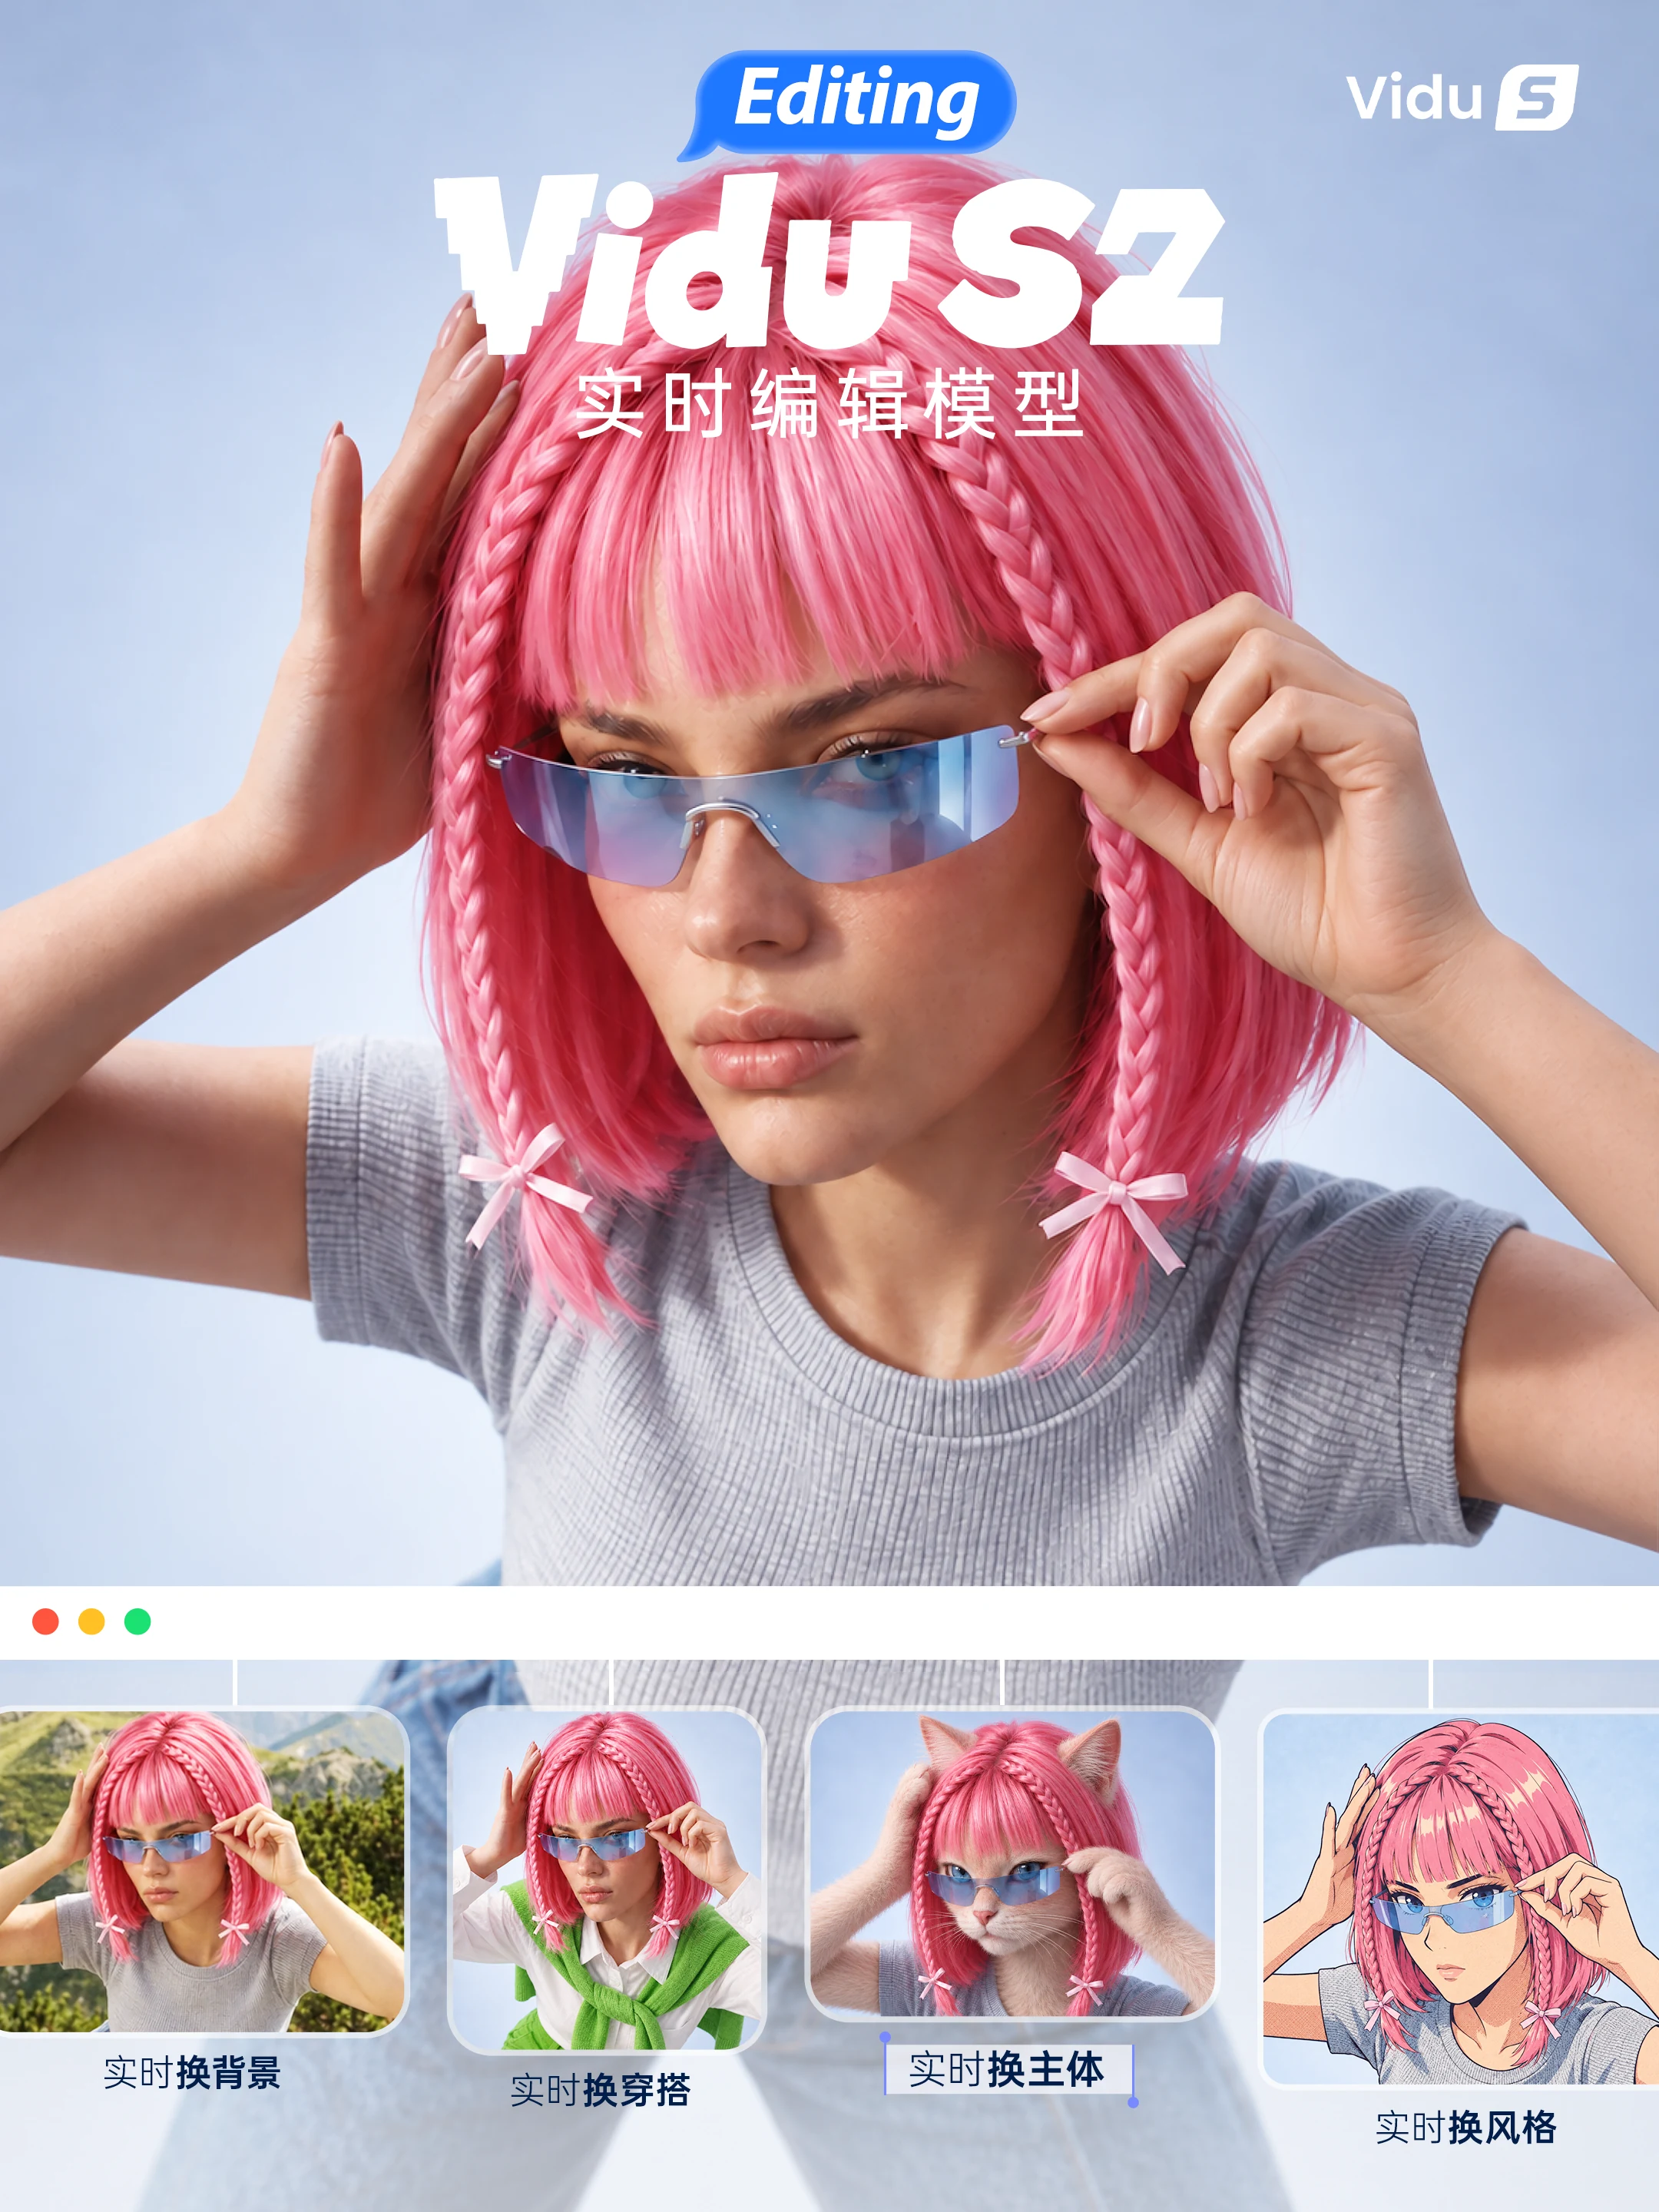
Vidu S2-Editing:实时编辑模型
- 根据风格参考图实时编辑视频风格,使视频画面流呈现不同美学质感
- 根据服装参考图实时编辑人物服装,实时生成多样穿搭效果
- 根据主体参考图实时替换人物,实时替换原视频流中的人物
- 根据背景参考图实时编辑视频背景,实时替换人物背景环境
这意味着,实时视频模型开始从「持续生成内容」,进一步演进为能够持续生成、持续交互、持续编辑的视觉系统。
Vidu S2-Avatar:拓展实时交互边界
Vidu S1 已经实现基于语音指令的实时视频生成和持续互动。
但在 S1 中,实时角色能力仍主要集中在数字人对话场景:实时生成分辨率为 540P,角色参考在视频流开始后基本固定,对舞蹈等大幅度身体动作的控制能力也仍然有限。Vidu S2-Avatar 在此基础上进一步扩展实时交互边界。
更强动作跟随:从“语音驱动表达”到“语音控制行为”
为了让模型学习更复杂的行为,我们进一步引入高质量单人舞蹈视频、2D 动画与 3D 动画数据。
对于具有平滑镜头运动的视频,我们不再直接过滤,而是通过背景稳定算子消除镜头运动对背景一致性的影响,让模型既能学习更丰富的身体动作,又能保持长期场景稳定。与此同时,我们重新设计视频 Caption。
传统 Caption 更关注“画面里有什么”。Vidu S2 则采用按时间顺序组织的描述,明确描述动作发生的时间、顺序和结果。
例如:
0–2.8 秒:角色抬起右手并向镜头挥手
2.8–5 秒:角色放下手臂,微笑并轻轻点头
模型学习的不只是静态语义,而是:什么动作先发生,什么动作后发生,当前状态应该如何延续。
这使 Vidu S2-Avatar 能够更准确地理解复杂动作和连续行为,并降低在动作切换、指令更新时的响应延迟。
动态参考:让交互过程持续变化
传统生成模型通常要求用户在生成开始前确定所有参考条件。
一旦视频开始生成,角色、服装、物体与场景基本已经固定。
Vidu S2-Avatar 进一步支持:在视频流运行过程中,随时输入新的参考图。
用户可以上传一个物体,让角色实时与它发生互动;上传一件服装,让角色完成换装;上传一个新场景,让角色进入新的环境。
参考图不再只是生成开始前的一次性条件,而成为了实时交互过程中的动态输入。
为了提升这一过程的可靠性,我们进一步引入 VLM Agentic System。
用户可以输入文本、语音、初始图像和参考图,VLM Agent 会结合用户意图、当前画面与参考内容,生成后续 Prompt,并持续检查模型输出。
例如,当用户说:
“拿起杯子,然后微笑。”
当角色完成“拿起杯子”后,系统会继续保持“角色手中正在拿着杯子”这一状态,在执行“微笑”时不会丢失前一个动作结果。
交互因此从:用户输入 → 模型生成,进一步升级为:
用户输入 → 理解当前状态 → 执行动作 → 检查结果 → 保持状态 → 响应下一条指令
实时角色开始具备更连续的状态理解和行为衔接能力。
Self-Replay Forcing:提升长程实时生成稳定性
实时视频最大的技术挑战之一,是误差累积。
传统离线 Diffusion 可以在完整视频范围内反复去噪,而实时生成需要按照 Chunk 持续向后生成。后一个 Chunk 依赖模型此前已经生成的内容,因此一次微小的身份偏差、动作误差或画面失真,都可能持续向后传播,最终造成角色漂移、动作不连续甚至视频崩坏。
为此,我们提出 Self-Replay Forcing(SRF)。模型首先按照真实推理方式执行长程 Autoregressive Rollout,获得自身生成的视频轨迹;随后,从这条轨迹中抽取连续片段,重新加入 Diffusion Noise,并进行可微分的 Causal Replay。相比传统 Self-Forcing,SRF 让模型能够在更接近真实推理分布的历史状态上学习,同时让 Replay 片段中的多个 Block 保持在同一个计算图中,使后续片段的 Loss 可以向前传播。
简单来说:模型不仅学习“下一段视频该如何生成”,也开始学习“如何避免自己此前生成的错误持续放大”。
在此基础上,我们进一步结合 DPO 与 Streaming NFT,提升实时流式生成中的视觉质量、动作自然度和指令遵循能力。
720P · 25–42 FPS:分开处理时序与细节
S2-Avatar 使用轻量级单步 Refiner,在主干模型的低分辨率输出上恢复高分辨率细节。主干侧重动作与长程时序,Refiner 侧重局部外观,以较低的额外计算开销将实时输出提升至 720P。
训练素材也按实际清晰度筛选,综合考察纹理、边缘和压缩损失。同为 1080P 的视频,经过不同程度的压缩,能提供的有效细节可能相差很大。
推理方面,我们沿用并扩展 TurboDiffusion 与 TurboServe 的部分技术,结合混合注意力、低比特计算和算子融合降低计算开销。在编辑流程中,编码器、生成主干、Refiner 与解码器沿共享时间线调度,在不同阶段复用 GPU,减少资源闲置与端到端延迟。
Vidu S2-Editing:让正在发生的视频实时可编辑
如果说 Vidu S2-Avatar 解决的是:
如何实时生成一个持续响应的角色。
那么 Vidu S2-Editing 解决的是另一个问题:
如何让正在发生的视频本身,也能够被实时编辑。
传统视频编辑通常遵循:录制视频 → 导入素材 → 编辑 → 渲染 → 输出
而 Vidu S2-Editing 将这一流程变为:Live Video Stream → Real-Time Editing → Live Output
用户既可以通过文本指令定义编辑目标,也可以上传参考图控制目标外观。视频开始从“生成后再修改”,走向在发生的同时被修改。
Frame-Aligned Attention:改变视觉内容,保留原始动作
实时编辑的关键,并不是“能不能把画面改掉”。真正困难的是:改变之后,原来的视频还能不能保持。换装时,人物的手仍然应该位于原来的位置;主体替换后,人物动作和镜头轨迹不能发生漂移;背景变化后,前景与场景之间仍然要保持稳定空间关系。如果模型只是重新生成一段类似视频,就容易出现动作偏移、时间漂移或人物结构变化。
因此,Vidu S2-Editing 引入了 Frame-Aligned Attention。其核心原则是:每一个目标帧,只读取相同时间位置的源视频帧。
这样,模型可以尽可能保留原视频的:动作、时序、姿态、镜头运动和场景结构。与此同时,Reference Image 持续对所有目标帧可见,为模型提供新的风格、角色、服装或背景信息。
最终形成:
Source Video:负责动作 / 时序 / 结构
↓
Reference:负责风格 / 角色 / 服装 / 场景
↓
Real-Time Edited Video
因此,Vidu S2-Editing 并不是重新生成一段“相似视频”,而是在尽可能保留原始运动和时间轴的基础上,对视频进行实时重构。
50+ 风格:让视觉表达实时变化
为了构建实时风格编辑能力,我们训练了一套基于 Surface Normal 条件的视频生成模型。模型首先理解原视频中的空间结构与运动,再根据新的参考图重构目标视觉外观。这使模型能够:改变风格,同时保持原视频空间结构和动作。
目前,Vidu S2-Editing 已能够泛化到 50+ 写实与非写实风格,包括:赛璐璐、赛博朋克、莫奈绘画、素描、中国工笔画等。风格因此不再只是生成前的一项固定参数。它开始成为视频运行过程中可以实时改变的视觉变量。
实时换装、换主体、换背景:从视觉特效到实时重构
除了风格迁移,Vidu S2-Editing 进一步支持完整的视频内容编辑。
实时换装
在人物持续运动过程中实时改变服装,同时保持服装边界、纹理,以及手与衣物之间的遮挡关系。
技术报告的虚拟试衣案例中,Vidu S2-Editing 能够在较大身体和手臂动作下保持服装稳定,并完成全身服装迁移。
实时换主体
模型可以将参考角色的完整视觉身份迁移到源视频,包括面部身份、发型、服装和身体外观,同时保持源视频的 姿势、动作、 镜头轨迹 和 场景空间结构。
实时换背景
在人物持续运动的情况下,模型可以将背景实时替换为新的环境,同时保持前景姿态、运动、场景几何和前后景空间关系。
实时编辑因此不再只是局部视觉特效。它开始成为一种实时重构视频世界的能力。
实时空间视频:从二维视频走向空间交互
在 Vidu S2 中,我们还进一步探索了 Real-Time Spatial Video Generation and Editing。
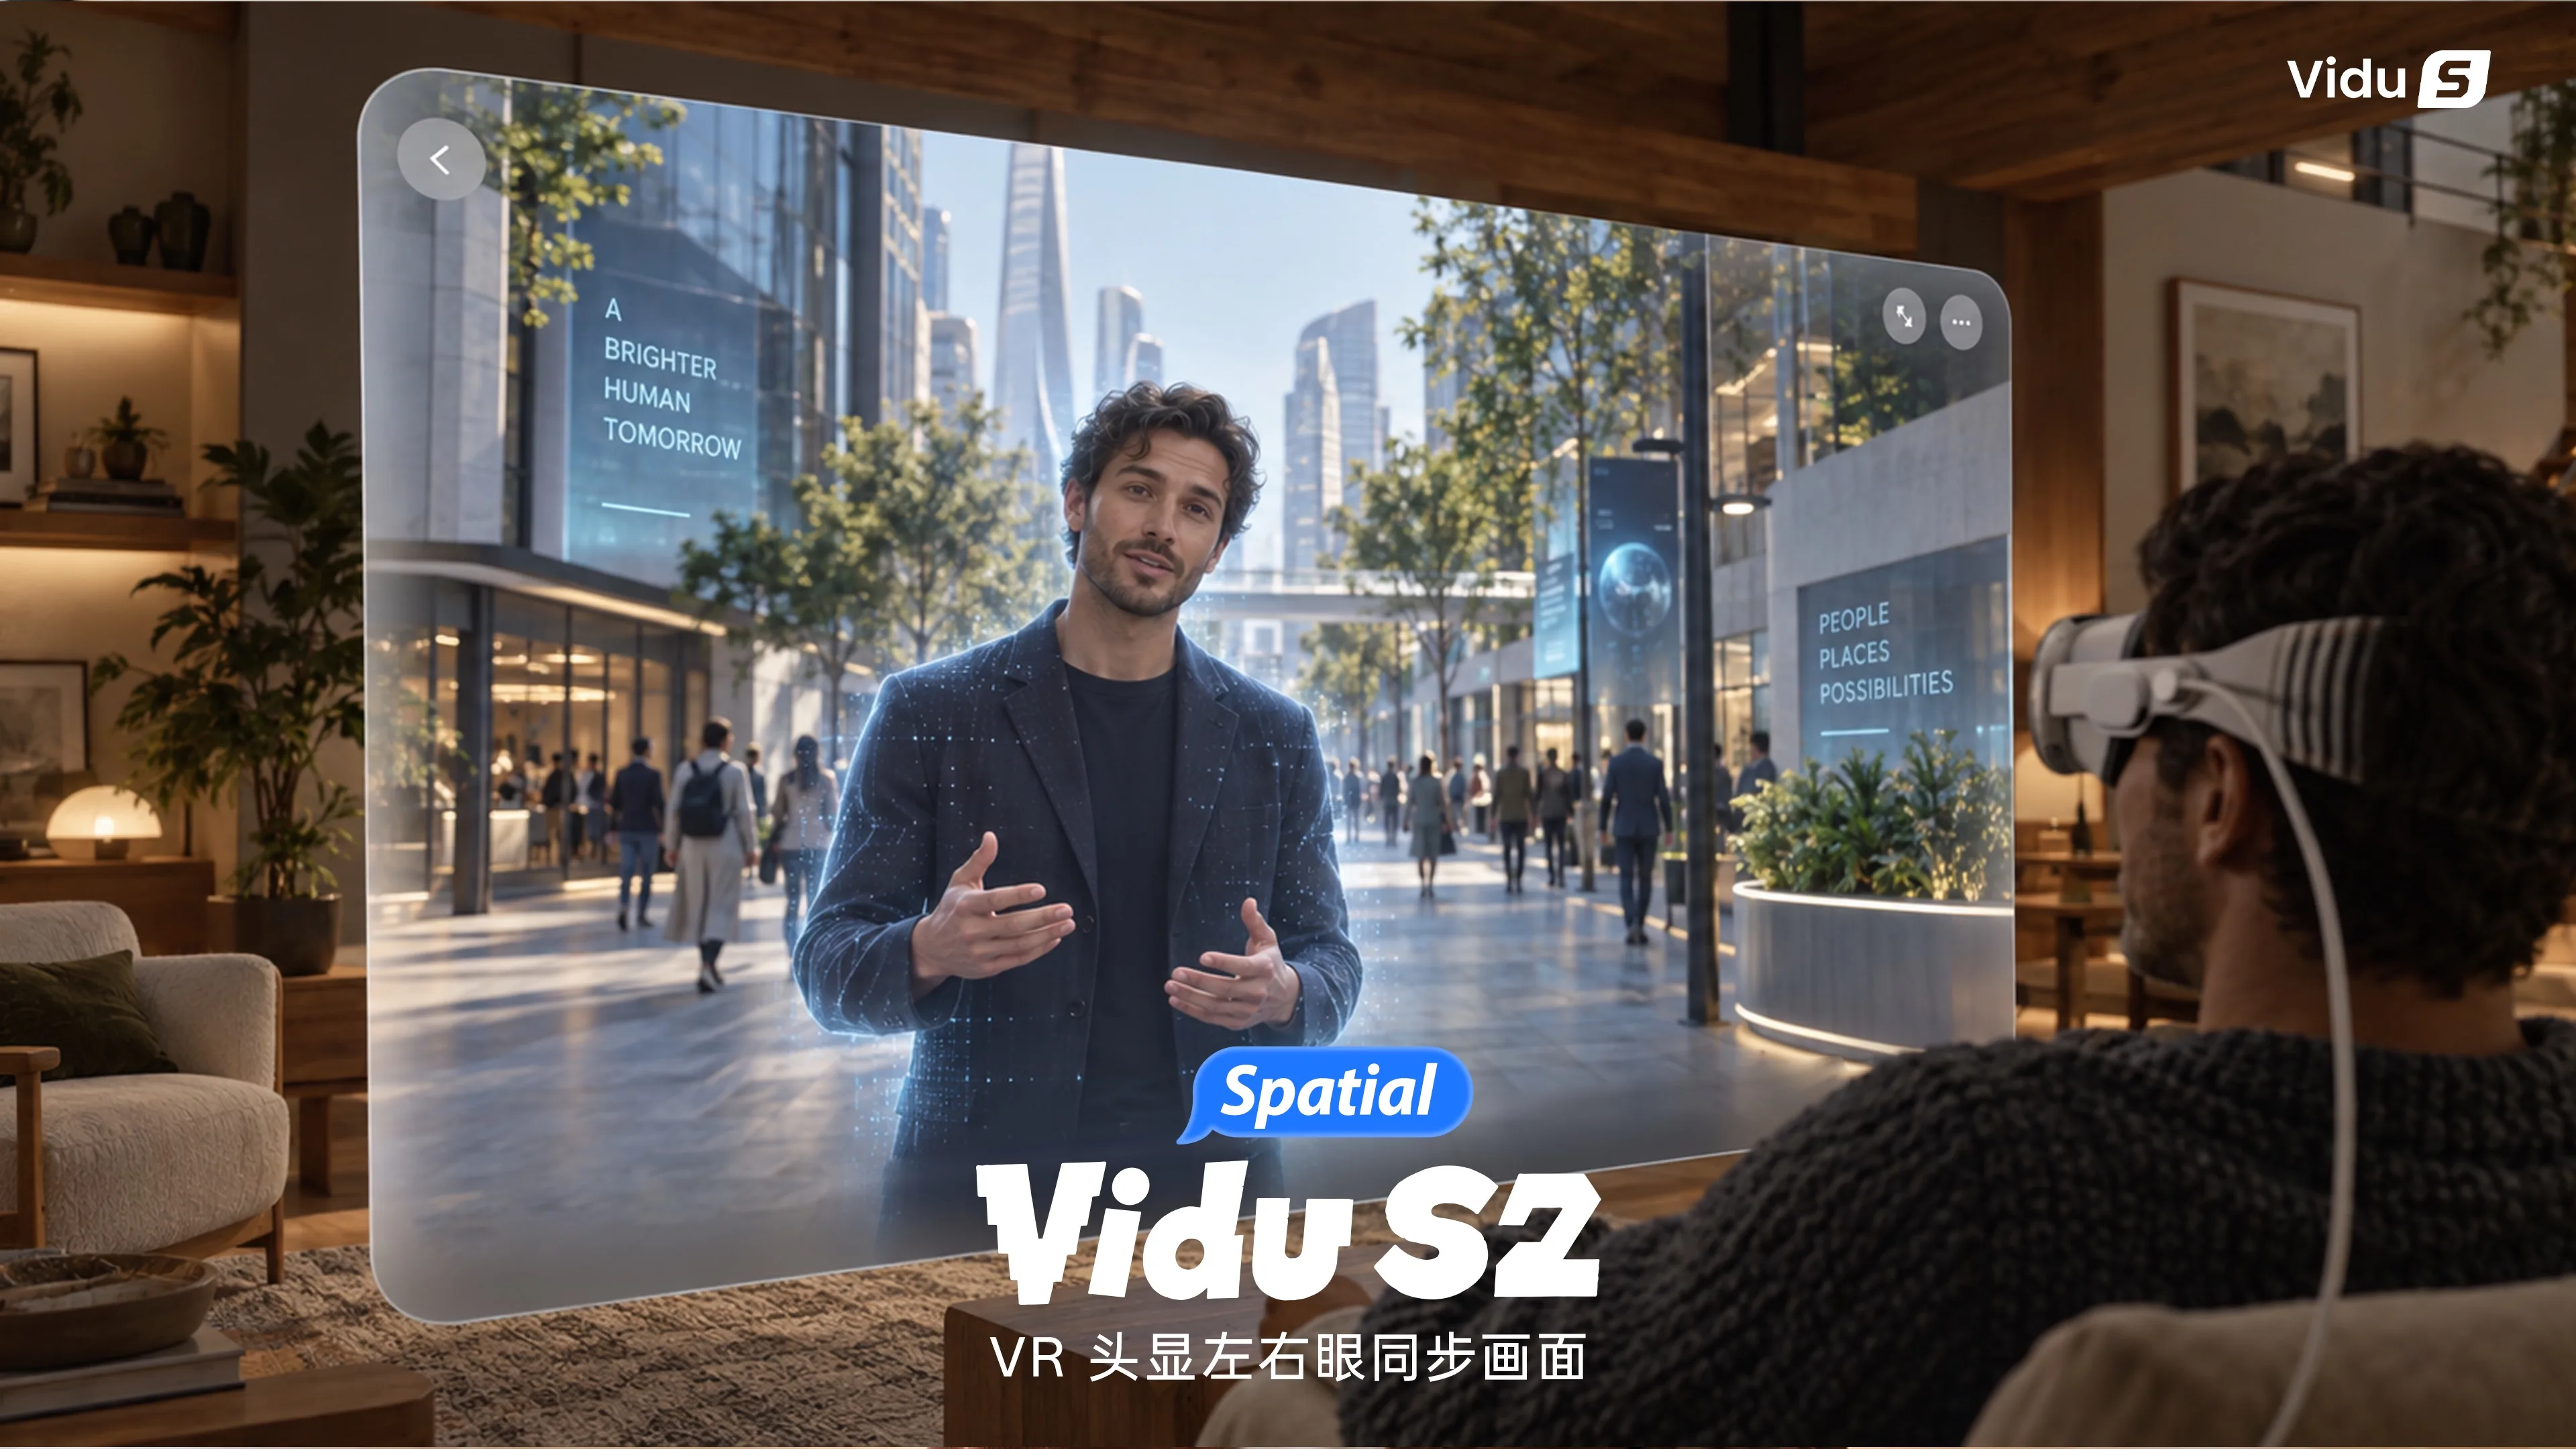
对于 Vidu S2-Avatar,单目实时视频可以通过深度估计与 Stereo Conversion,转换为同步左右眼视图。
对于 Vidu S2-Editing,则同时支持:单目视频 → 实时编辑 → 空间视频转换
以及:双目视频 → 联合实时编辑 → 左右眼输出
风格迁移、虚拟试衣、角色替换和背景替换,都可以继续应用于空间视频。这使实时视频进一步具备进入 VR、XR 和 Passthrough 场景的技术基础。未来,实时生成的视频可能不再只存在于二维屏幕中。
整个视觉空间,都可以随着用户交互实时生成、实时编辑和持续变化。
Vidu S2 背后的技术体系
实时交互与实时编辑,并不依赖单一技术突破。它要求模型架构、训练算法、推理优化与系统部署协同工作。
在 Attention 层,我们采用逐层 Hybrid Attention,根据不同 Layer 对精度的敏感程度,在:SageAttention、SpargeAttention、Sparse-Linear Attention之间选择不同计算方案。在线性层,我们开发 per-block W8A8 GEMM,降低 Linear Layer 的计算和显存成本。
在 Kernel 层,我们进一步采用:Triton / CUDA Kernel Fusion、CUDA Graphs、Launch Optimization减少 Kernel Launch、同步以及中间 Tensor 的显存读写。在多 GPU 推理层,我们使用 Ulysses-style Context Parallelism,并对 GPU 间传输 Tensor 进行量化,以减少通信成本。
对于 Vidu S2-Editing,我们进一步让 VAE Encoder、Backbone、Refiner 和 VAE Decoder 沿同一执行时间线动态共享 GPU。当一个模块暂时不需要某张 GPU 时,其他模块可以立即复用该资源,从而减少 GPU 空闲时间,进一步降低端到端推理延迟。
这些模型侧与系统侧优化,共同构成了 Vidu S2 实时交互与实时编辑能力的技术基础。
多项基准测试领先
在 StreamAV-Bench 中,Vidu S2-Avatar 在技术报告公布的所有指标上均取得最佳结果,覆盖:视觉美感、视觉质量、音频质量、音视频语义对齐、音视频同步、指令满足、主体一致性和背景一致性等多个维度。
在视频编辑 Benchmark 中,Vidu S2-Editing 同样取得领先结果。
在人类偏好评测中,Vidu S2-Avatar 相比 Runway Character GWM-1、PixVerse Image Avatar 和 HeyGen,在总体质量、动作、表达、语义遵循与长期稳定性等维度获得更高偏好。
Vidu S2-Editing 相比 XMax-X2.0 和 Decart-Lucy2.5,在总体质量、视频质量、时间一致性和语义遵循等指标中同样获得更高偏好。
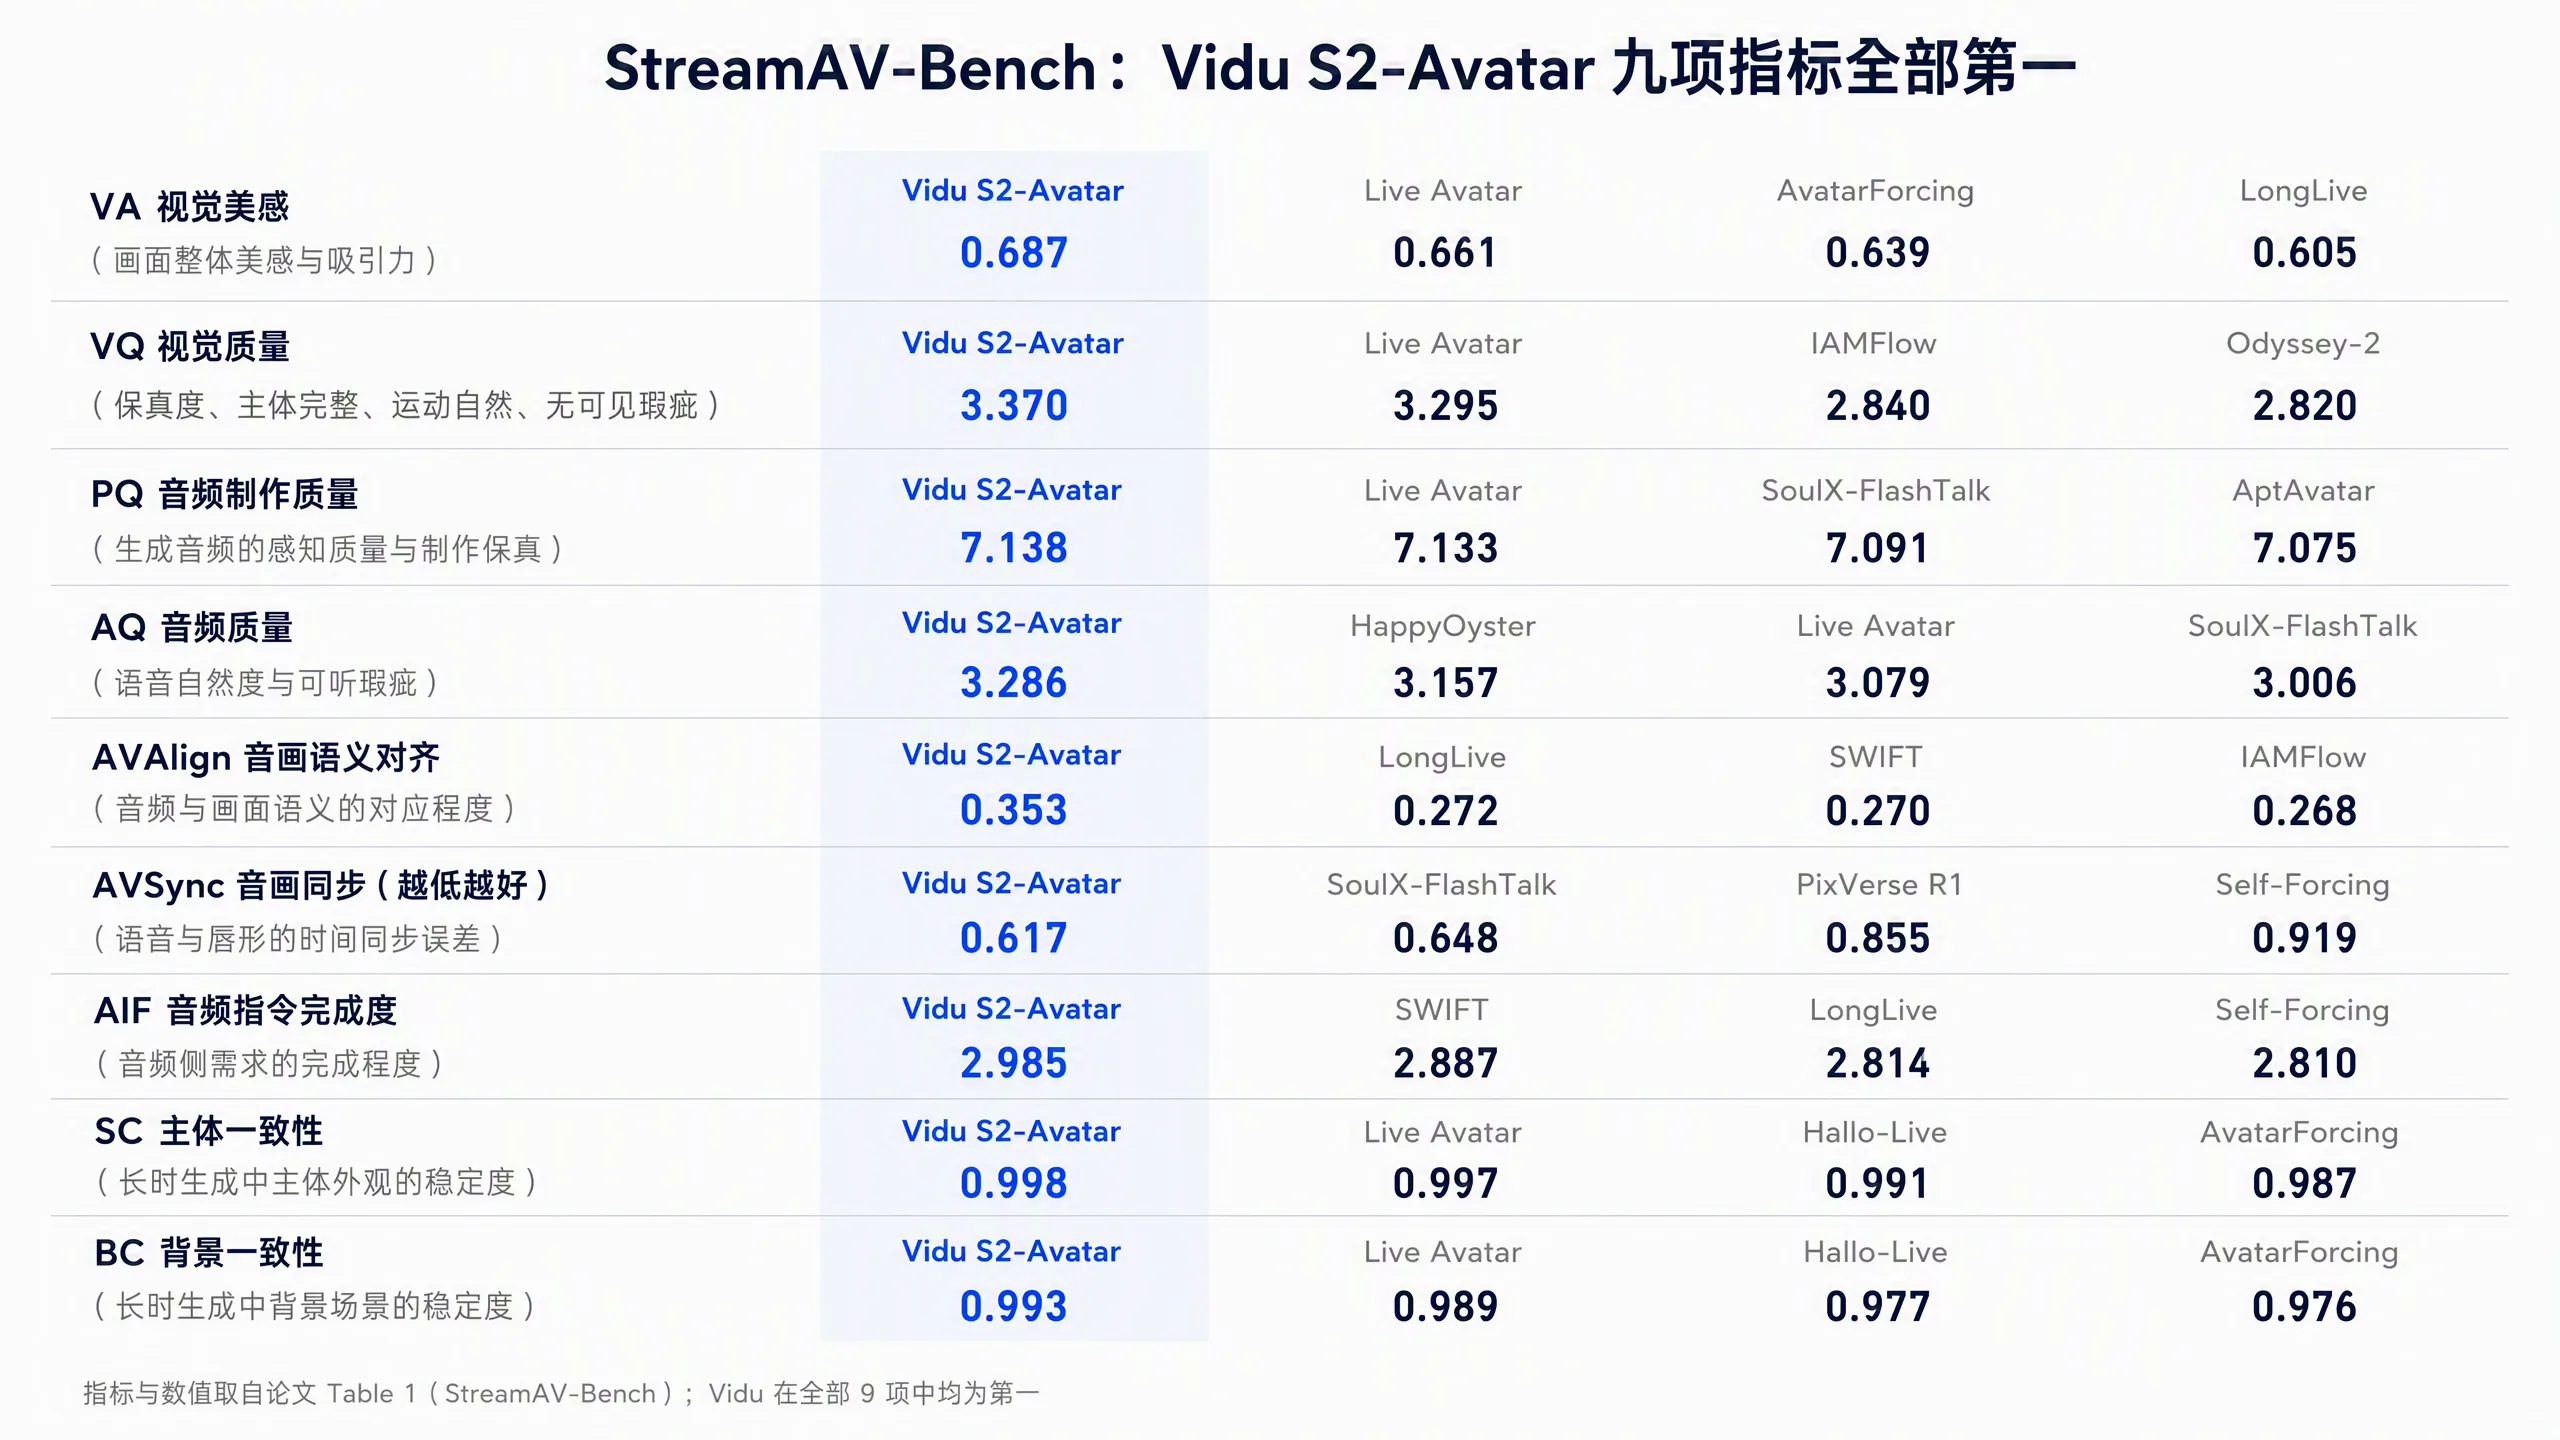
S2-Avatar 在 StreamAV-Bench 对比中取得画面、音频、音画协同、主体与背景一致性等 9 项最优。
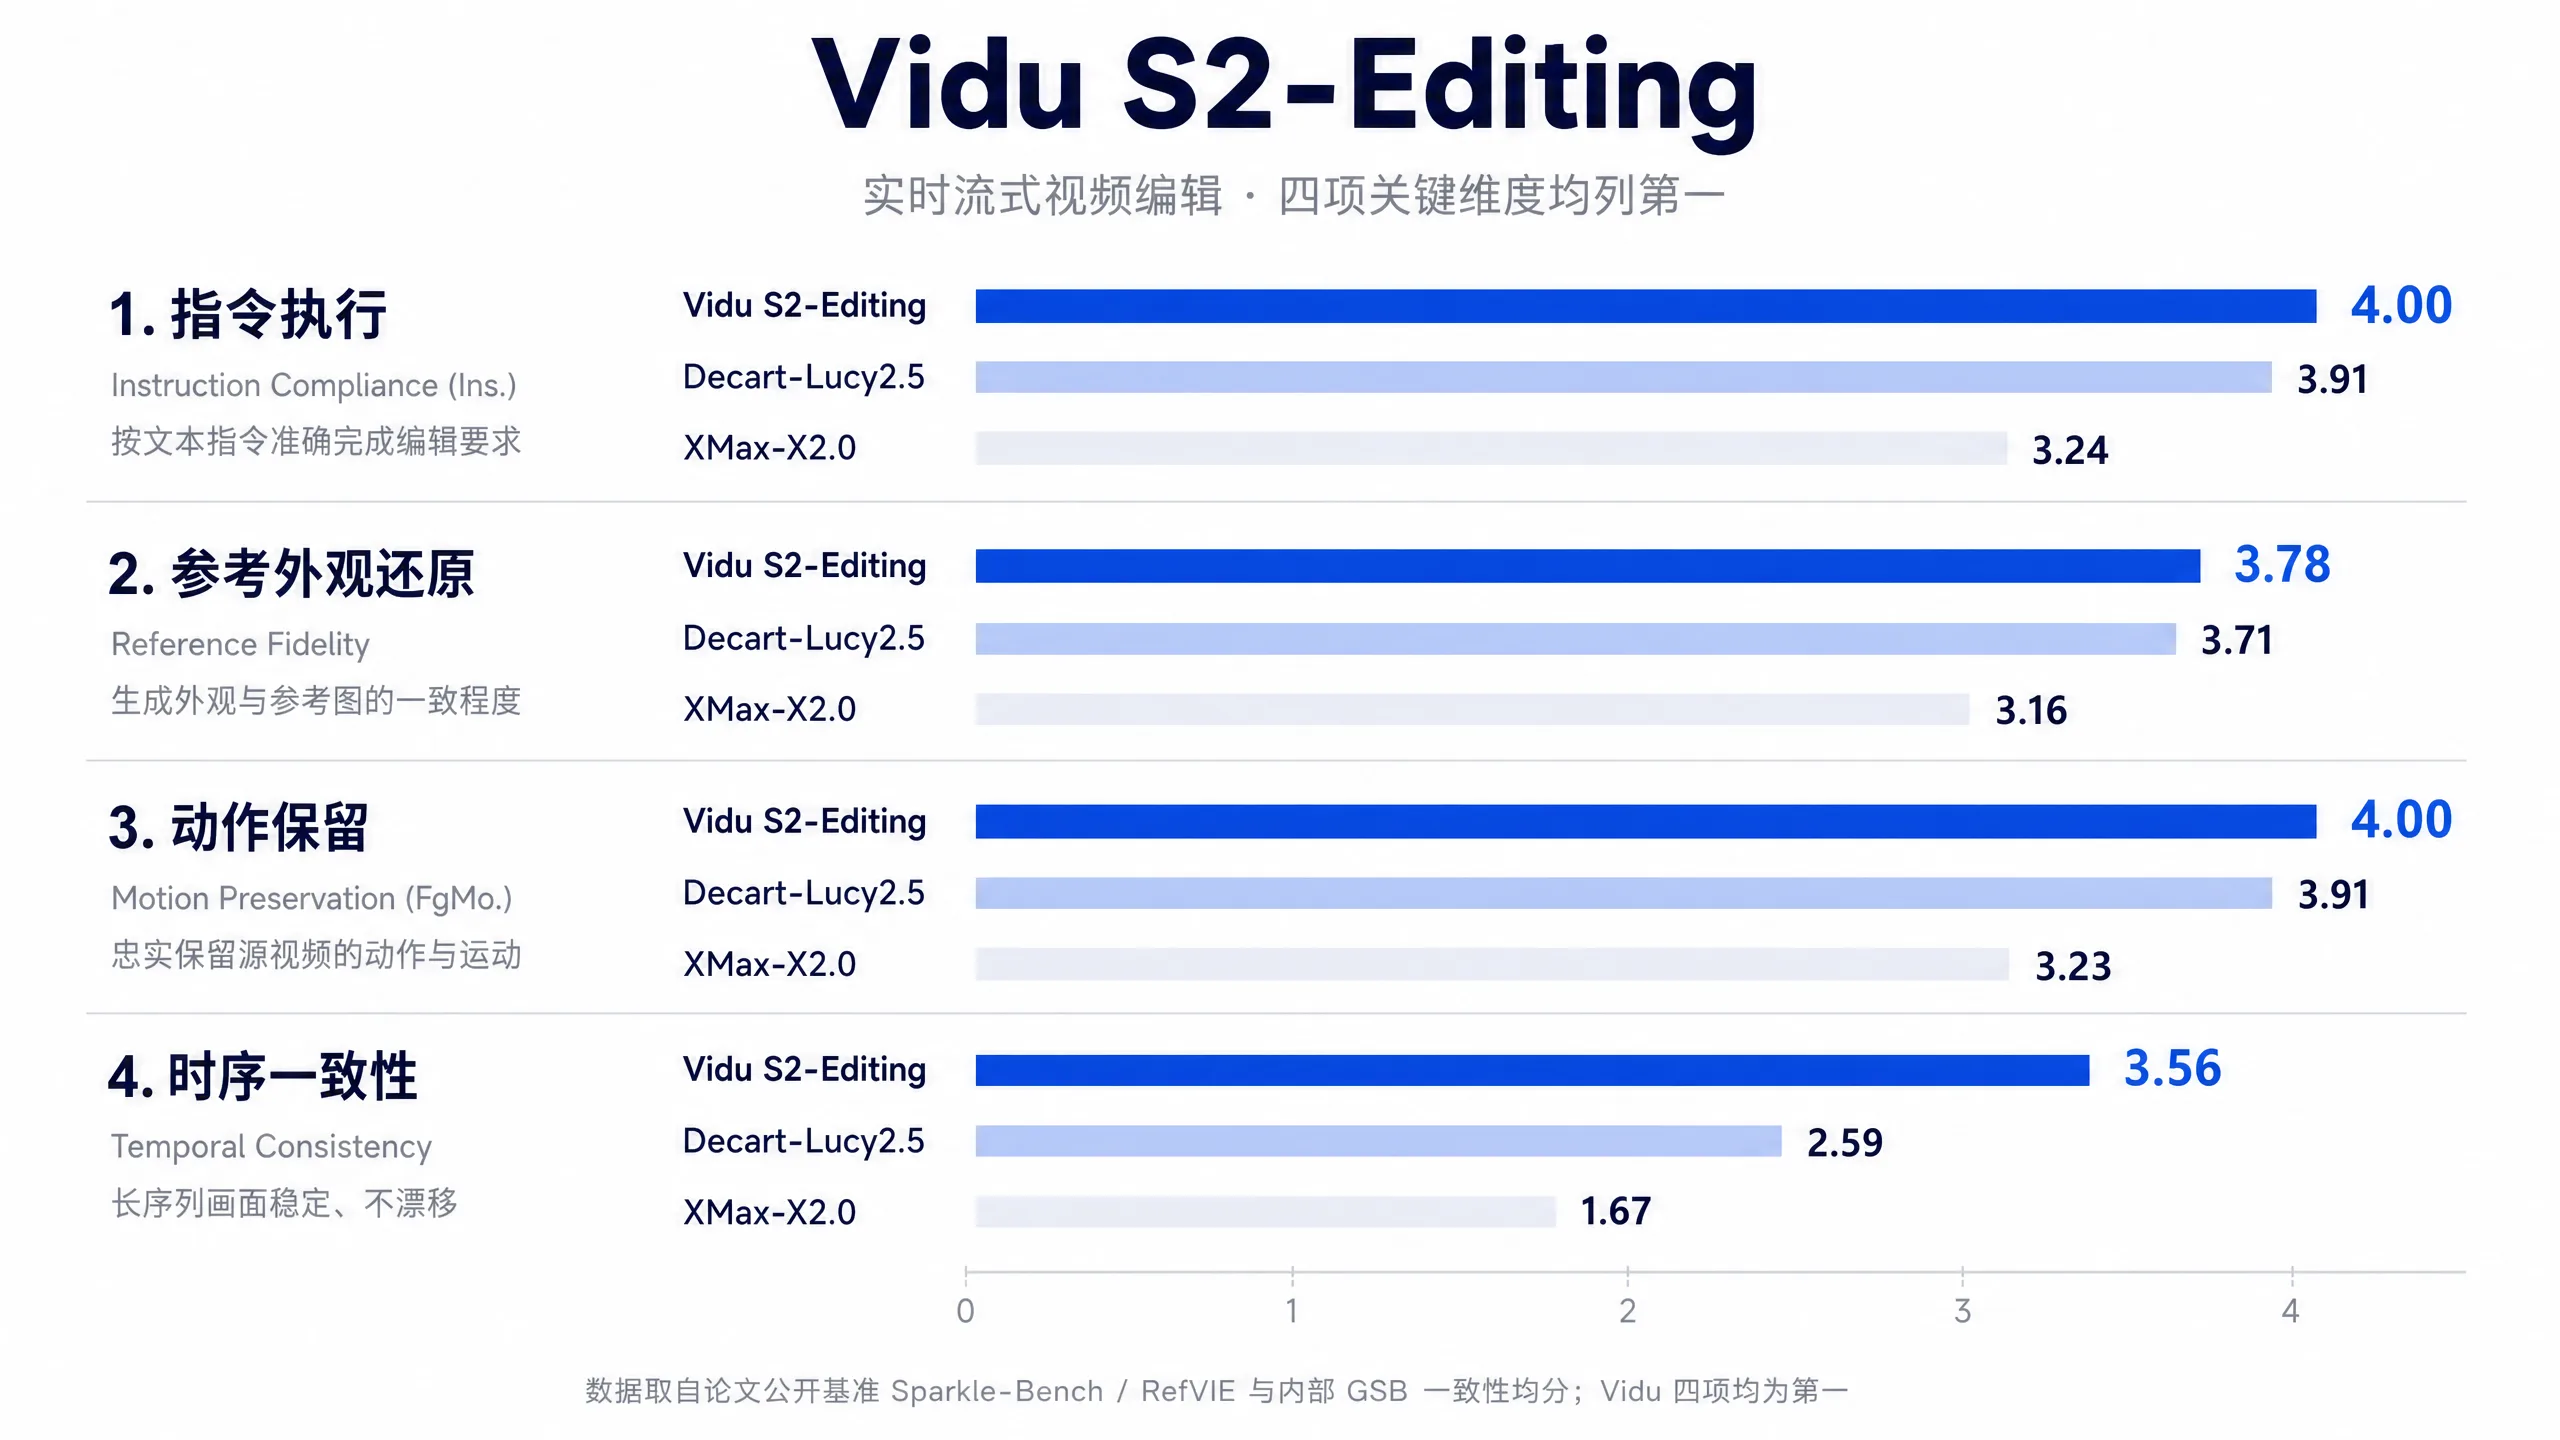
Vidu S2-Editing 在指令执行、参考外观还原、动作保留与时序一致性等关键维度均取得领先成绩。
从实时生成,到实时交互与实时编辑
从 Vidu S1 到 Vidu S2,我们持续推进同一个方向:
让视频从一次性生成的内容,演进为可以持续响应、持续改变的交互载体。
S1 实现了实时生成与持续互动。S2 则进一步把实时能力扩展到:复杂动作,动态参考,实时编辑,实时空间视频。视频不再只是“生成出来被观看”。它开始在发生的同时理解用户、响应用户,并随着交互不断变化。
从实时生成,到实时交互,再到实时改变。
这是 Vidu S2 对实时视频能力边界的进一步拓展,也是 Vidu S 系列持续探索的方向:让视频成为一个实时响应、持续变化的世界。
Vidu S2 已正式开放体验,欢迎使用。
🎮 立即体验: https://vidu.com/vidu-stream
🛠️ API 平台: http://platform.vidu.com/vidu-stream/doc
📄 技术报告: https://arxiv.org/pdf/2609.11638
Vidu S 致力于实现人类极致的视觉交互享受。