Motus2:面向灵巧操作的自进化通用世界模型
通用灵巧操作不仅要求模型从大规模交互中学习可迁移的经验,还要求它在手部自遮挡下保留任务相关信息、理解视觉难以判断的接触状态,并在监督模仿之外持续改进策略。然而,现有机器人基础模型主要依赖成本高昂的机器人示范进行动作学习,既难以规模化获取交互经验,也缺少根据执行结果判断行为优劣并进一步优化策略的机制。
为此,Motus2 构建了一个面向灵巧操作的自进化通用世界模型 [5]:通过从单目到同步双目的第一视角数据预训练与机器人域适配,将大规模人类交互经验迁移到机器人控制;通过共享参数的策略、模拟器和评估器预测并评价候选动作的后果,再利用基于模型的强化学习将价值反馈转化为策略更新;同时引入工作记忆和触觉专家,以增强长时任务中的历史信息保留与接触感知能力。
真实应用展示
在 Screw Bulb 任务中,机器人需要用右手将灯泡对准灯座并持续旋入,直至灯泡点亮后再松开。这一过程同时要求精确的空间对齐、稳定抓握与持续接触控制。
在 Multi-Finger 任务中,机器人需要从一组形状各异的物体中完成多指抓取,并将目标物体放入指定容器。该任务用于考察高自由度灵巧手的多指协调与精细操作能力。
在 Find Square 任务中,目标方块被藏入三个杯子之一,随后杯子位置被打乱。机器人必须保留目标被遮挡前的视觉信息,并据此掀开正确的杯子,体现长时视觉上下文对部分可观测任务的重要性。
在 Tear Paper 任务中,机器人通过双手协同从卷纸上撕下一张纸。由于撕裂过程中的接触与受力状态难以仅凭视觉准确判断,该任务重点考察触觉反馈支持下的双手协调控制。
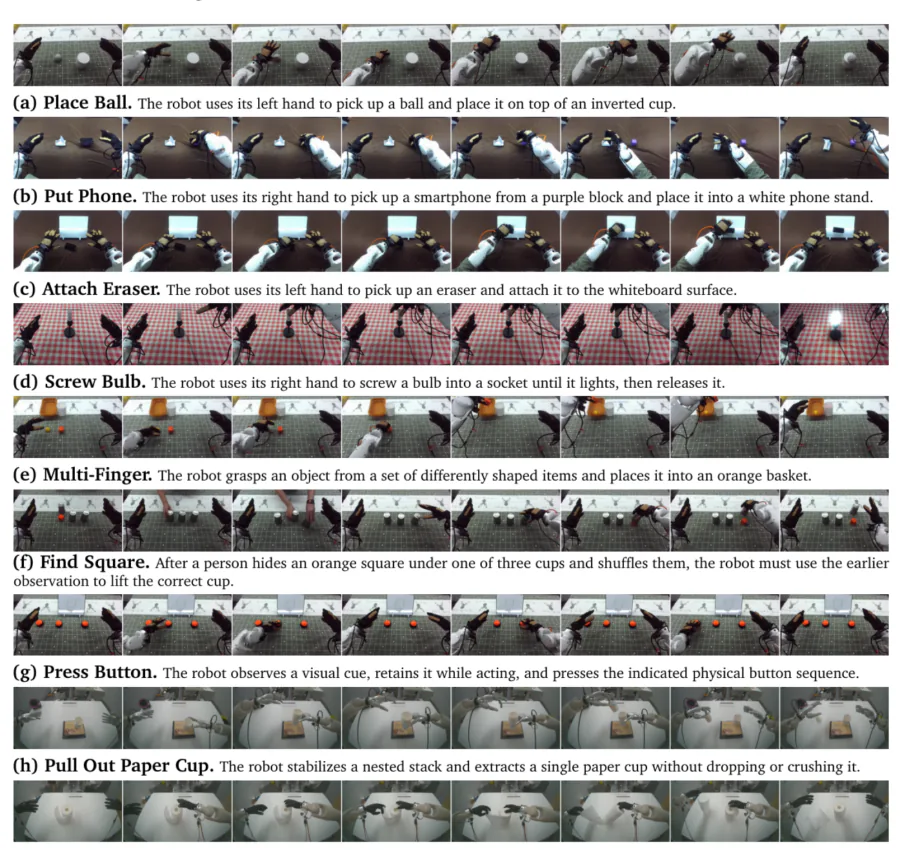
图 1:Motus2 的九项真机评估任务。每行展示一次代表性执行中的八个采样帧。
技术方法
Motus2 沿两条轴线扩展灵巧操作能力:通过分层的第一视角人类数据金字塔实现数据扩展,通过具有显式策略改进闭环的通用世界模型实现模型扩展。
模型扩展:自进化闭环
Motus 通过 UniDiffuser 式的视频–动作联合建模,在一个共享模型中统一了策略接口(世界–动作模型)和模拟器接口(动作条件世界模型)[1,4]。然而,预测动作后果并不能说明该结果是否推进了任务。Motus2 因此引入由价值模型实现的第三种控制接口——评估器,用于评估预测结果并为策略改进提供信号。
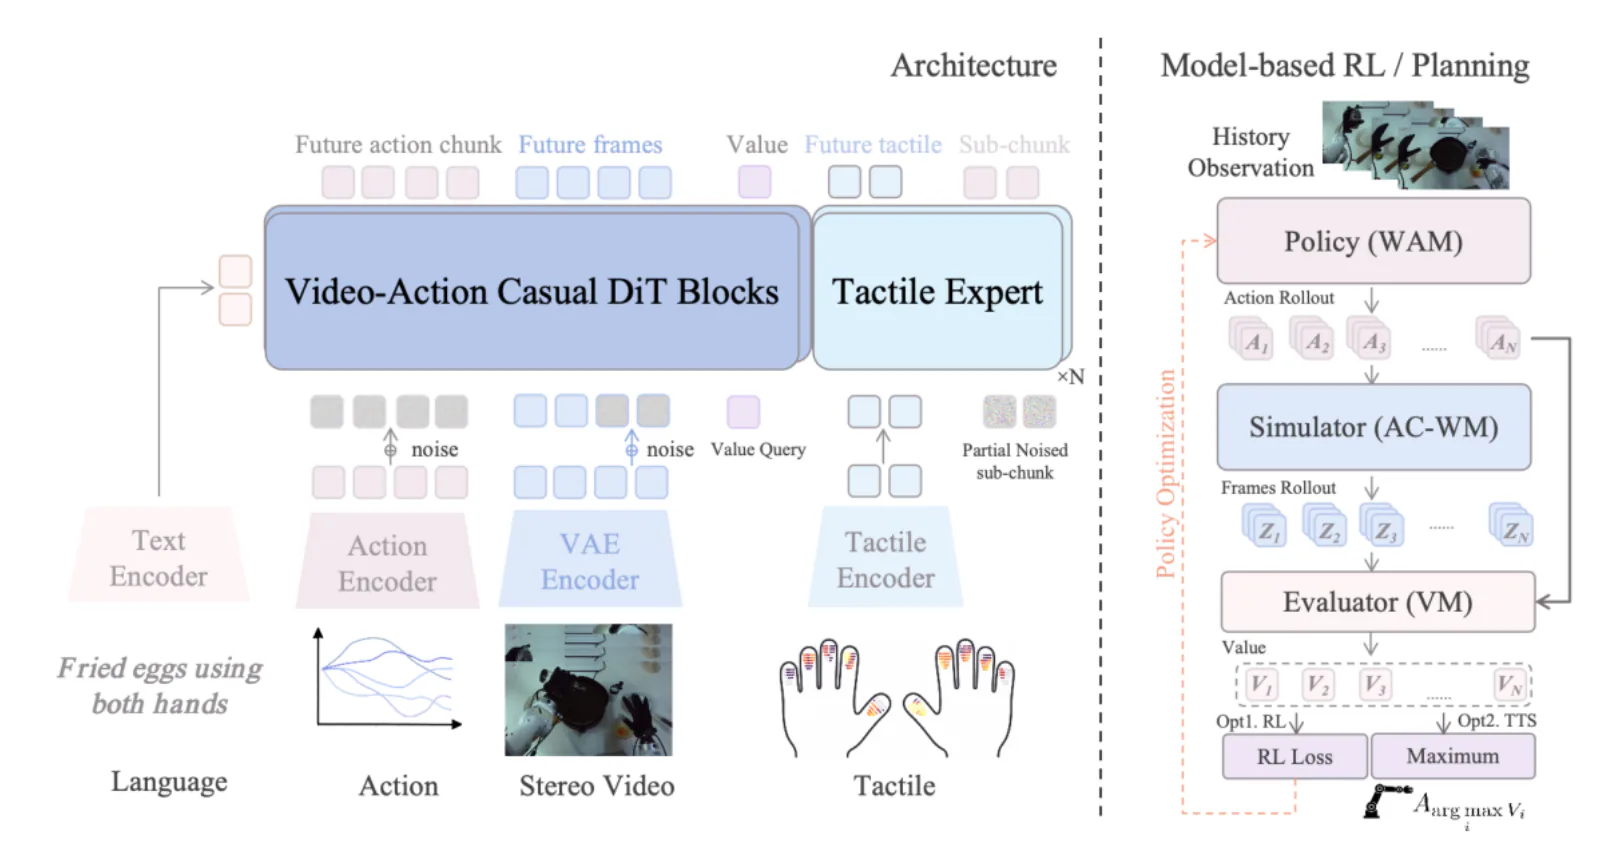
图 2:Motus2 使用一个共享参数模型提供策略、模拟器和评估器三种控制接口。
三个接口是同一组参数上的不同条件查询:策略提出可执行动作块,模拟器预测这些动作带来的未来视觉结果,评估器估计预测结果对应的任务进展。三者遵循“上下文 → 动作 → 预测未来 → 价值”的因果顺序。动作优先的注意力机制保证动作无法读取当前分块中的未来视频和价值,而未来视频可以读取动作,价值则可以读取两者,从而避免未来信息泄漏到动作预测中。常规控制只需调用策略接口,只有规划或策略优化需要进一步生成未来视频和价值。
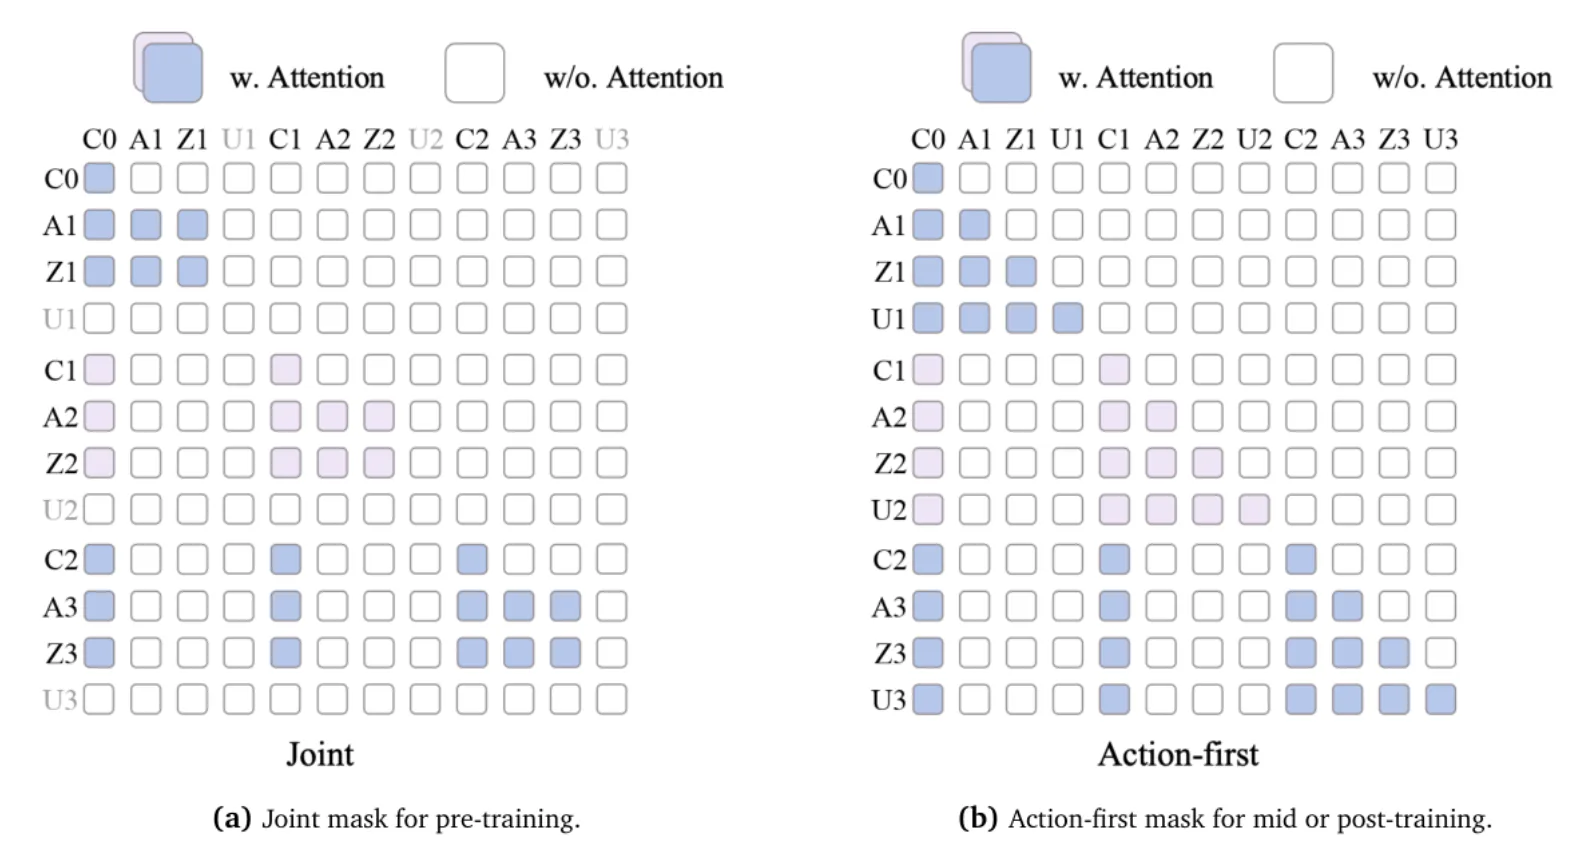
图 3:联合预训练采用视频–动作双向交互,机器人域中期训练和后训练采用动作优先掩码。
评估器的监督来自任务进度,正负目标按轨迹划分:成功轨迹的片段按其推进的相对进度获得正目标,失败的遥操作轨迹和与任务无关的交互获得负目标。同一套划分也决定了动作监督——只有筛选过的成功轨迹才激活动作学习,失败和次优的执行只用来训练模拟器和评估器,它们记录的动作在那里是干净的条件变量。模型由此从失败中学到动力学和结果评估,而不会被教会复现失败的动作。
这套接口同时支持测试时扩展和自进化闭环:
- 在测试时的 Best-of-$N$ 规划中,策略提出多个候选动作块,模拟器预测各自的未来,评估器对候选分支进行排序,机器人执行价值最高的分支,并在获得新的真实观察后重新规划。
- 在后训练阶段,DiffusionNFT [3] 将候选动作的价值估计转化为策略更新,提高高价值动作的生成概率,并抑制低价值动作。
其中,测试时规划只改善当前候选动作的选择,不改变模型参数;DiffusionNFT 则将模型预测的后果和价值估计反馈到动作策略,使策略改进不再仅依赖监督模仿,从而闭合决策与学习回路。
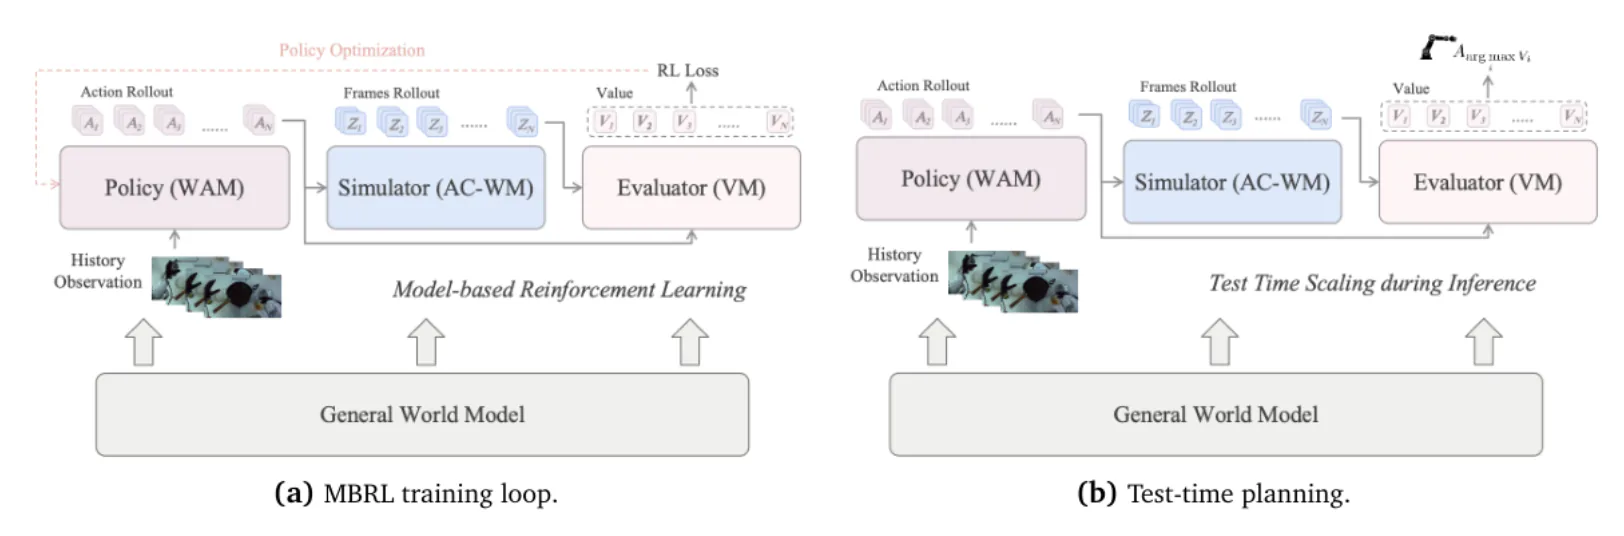
图 4:价值信号在后训练阶段用于策略更新,并在推理阶段用于候选动作选择。
数据扩展:从人类经验到机器人执行
模型扩展关注如何利用经验改进策略,数据扩展则关注如何获得可规模化的交互经验。真实机器人数据能够直接监督控制,却难以大规模采集;人类第一视角数据更容易获取,但无法直接转化为机器人动作。Motus2 建立了一条从人类交互到机器人执行的渐进式迁移路径,使大规模人类经验最终能够服务于机器人控制。
这条路径从单目第一视角视频开始。单目数据覆盖广泛的任务、物体和环境,为模型提供视觉、语义和手–物交互先验;随后加入同步双目视频与人类动作,利用双目视角提供的深度线索和更准确的三维手部姿态,将单纯的视觉经验推进为与动作关联的交互经验;最后通过机器人轨迹和人机对齐数据进行机器人域适配,把人类交互先验落到机器人可执行的动作空间 [2]。
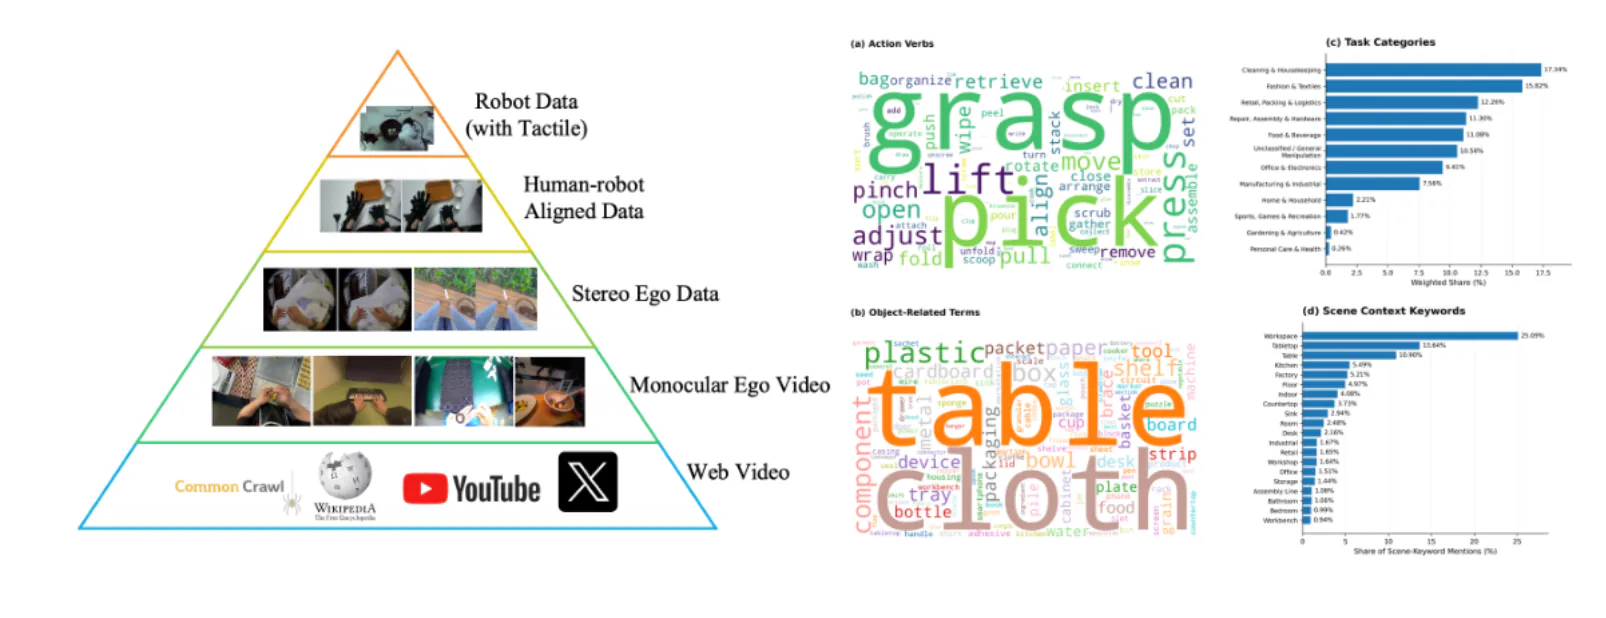
图 5:从单目与双目第一视角数据,到人机对齐数据与机器人交互数据的分层数据金字塔。
为此,Motus2 构建了约 13 万原始录制小时的第一视角语料,并在机器人域中期训练中使用超过 100 小时的机器人轨迹和补充性人机对齐数据。
Motus2 进一步使用 2k 到 20k 原始小时的嵌套双目子集验证这条路径的扩展潜力。随着数据增加,各规模下的最优留出动作预测误差持续下降,并与数据规模呈近似对数线性关系。
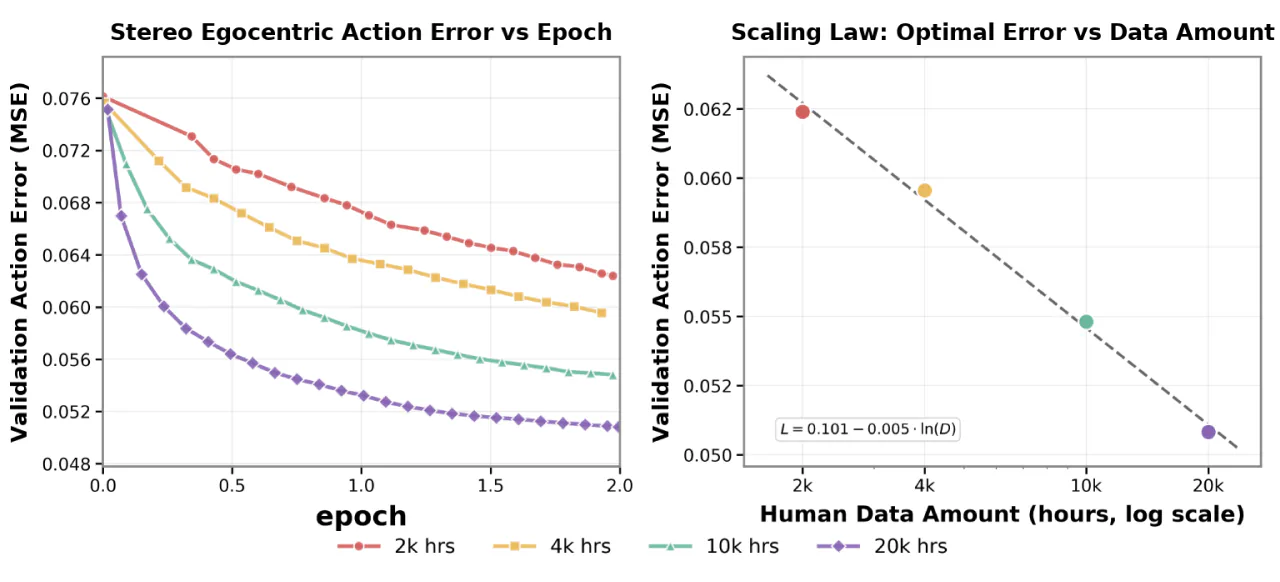
图 6:在论文测量的数据范围内,扩大同步双目人类数据规模能够持续降低留出动作预测误差。
工作记忆与触觉专家
除模型扩展与数据扩展外,灵巧操作还面临两个关键问题:一是手部自遮挡造成的部分可观测性,早期出现的任务相关信息可能在后续决策时已不可见;二是视觉对接触状态的观测存在歧义,指尖滑移、抓取形成和释放等关键事件难以仅从图像中准确判断。Motus2 分别通过工作记忆和触觉专家增强模型的时序上下文与接触感知能力。
针对长时任务中的部分可观测性,Motus2 以有界滑动窗口作为默认上下文,在固定缓存容量和单步计算开销下保留近期观察。在此基础上,Motus2 进一步研究了两种长历史机制:全局自回归保留完整观察历史,但计算开销随任务长度增长;混合记忆沿用 MemoryWAM [6] 的设计,完整保留初始锚点帧和近期观察,并将更早的中间历史压缩为持久记忆 token。
针对视觉难以消除的接触不确定性,Motus2 引入轻量级触觉专家,以高频触觉信号在动作执行前进行修正,而无需重复运行完整主干。主模型首先将完整动作块去噪至中间状态;在每个短动作子块执行前,触觉专家读取最新的触觉窗口并完成最终更新。训练阶段还引入未来力预测作为辅助监督,以学习动作与接触变化之间的关系;部署阶段则仅输出经触觉信息修正后的动作。
实验成果
Motus2 的实验分别验证了第一视角预训练与机器人域适配、价值引导的策略改进、长时上下文机制和触觉反馈。真机实验在相同初始配置与统一成功判据下进行,每项任务对每种方法评估 20 次。
第一视角经验能否迁移到机器人控制。 在 Place Ball、Multi-Finger、Attach Eraser、Screw Bulb 和 Put Phone 五项真机任务上,直接从视频基础模型初始化的 WAN-SFT 宏平均成功率为 0%;经过单目与双目第一视角预训练后,Pretrain-SFT 达到 51%;进一步进行机器人域中期训练后,Motus2 达到 84%。这表明,第一视角预训练与机器人域适配在数据扩展路径中发挥了连续而不同的作用。
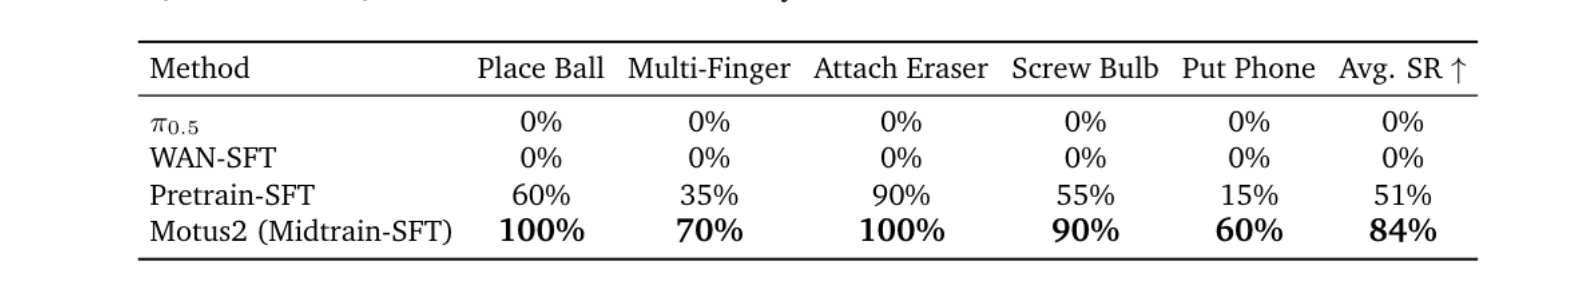
图 7: 主实验结果。
价值反馈能否改进策略本身。 在 Put Phone 和 Multi-Finger 两项任务上,基础模型的宏平均成功率为 65.0%。仅使用 Best-of-$N$ 规划时,成功率提升至 67.5%;使用 DiffusionNFT 进行基于模型的策略改进后,直接推理成功率达到 72.5%;同时使用策略改进与规划时达到 75.0%。相比只改变候选选择的测试时规划,DiffusionNFT 通过更新策略本身带来了更显著的提升。
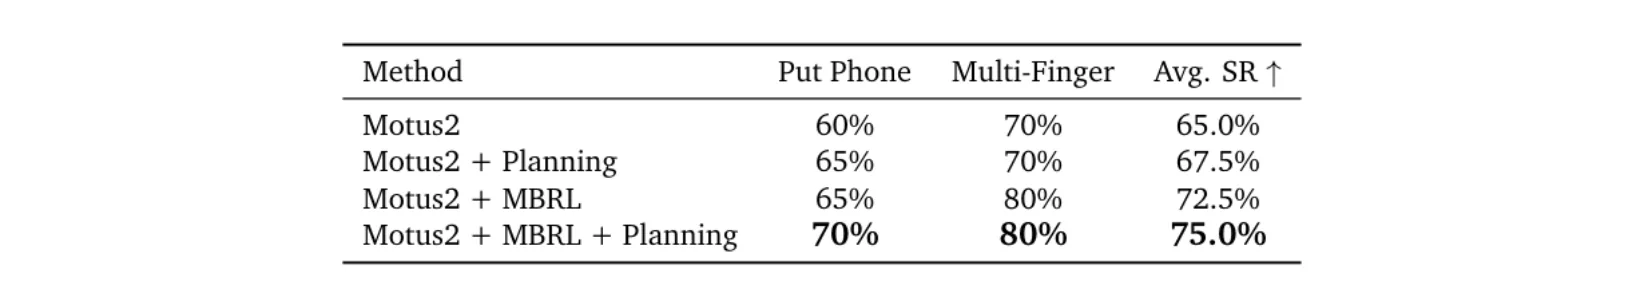
图 8: Motus2 策略改进与规划结果。
长时历史能否缓解部分可观测性。 在 Find Square 和 Press Button 两项记忆任务上,全局自回归在仿真中的宏平均成功率为 78%,高于混合记忆的 52%;在真机上,两者分别达到 57.5% 和 25.0%。结果表明,在所评估的长时任务中,保留完整视觉历史取得了更好的表现,但其计算开销也会随任务长度增长。
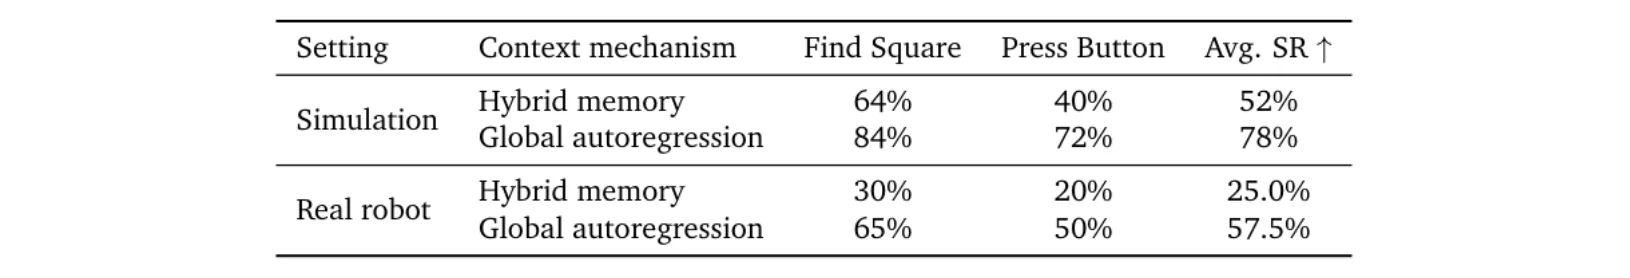
图 9: Motus2 长时上下文机制结果。
触觉反馈能否改善接触密集型操作。 在 Pull Out the Paper Cup 和 Tear Paper 两项真机任务上,引入触觉专家后,宏平均成功率由 60.0% 提升至 72.5%。其中,Pull Out the Paper Cup 从 65% 提升至 75%,Tear Paper 从 55% 提升至 70%。结果表明,触觉反馈能够改善所评估任务中的接触感知与动作修正。
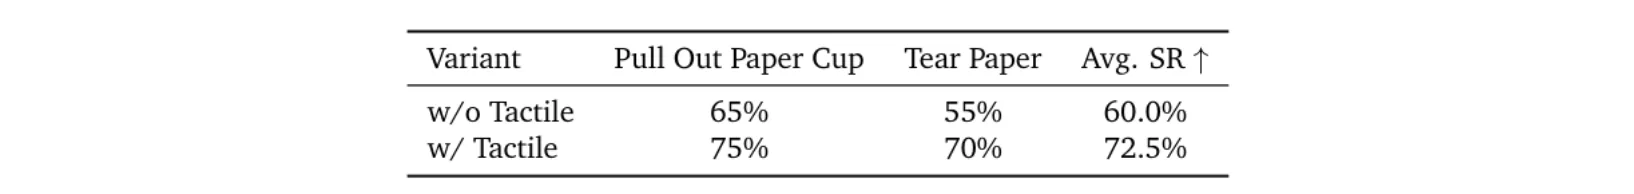
图 10: Motus2 触觉反馈消融结果。
参考文献
[1] Hongzhe Bi, Hengkai Tan, Shenghao Xie, Zeyuan Wang, Shuhe Huang, Haitian Liu, Ruowen Zhao, Yao Feng, Chendong Xiang, Yinze Rong, Hongyan Zhao, Hanyu Liu, Zhizhong Su, Lei Ma, Hang Su, and Jun Zhu. Motus: A Unified Latent Action World Model. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), pages 35101–35113, June 2026.
[2] Hongzhe Bi, Lingxuan Wu, Tianwei Lin, Hengkai Tan, Zhizhong Su, Hang Su, and Jun Zhu. H-RDT: Human Manipulation Enhanced Bimanual Robotic Manipulation. In Proceedings of the AAAI Conference on Artificial Intelligence, 2026.
[3] Kaiwen Zheng, Huayu Chen, Haotian Ye, Haoxiang Wang, Qinsheng Zhang, Kai Jiang, Hang Su, Stefano Ermon, Jun Zhu, and Ming-Yu Liu. DiffusionNFT: Online Diffusion Reinforcement with Forward Process. In International Conference on Learning Representations, 2026. Oral.
[4] Fan Bao, Shen Nie, Kaiwen Xue, Chongxuan Li, Shi Pu, Yaole Wang, Gang Yue, Yue Cao, Hang Su, and Jun Zhu. One Transformer Fits All Distributions in Multi-Modal Diffusion at Scale. In International Conference on Machine Learning, pages 1692–1717, 2023.
[5] Jun Zhu, Hengkai Tan, Jintao Zhang, Min Zhao, Fan Bao, and Bo Zhang. General World Models from First-Principles. Manuscript, 2026.
[6] Sizhe Yang, Juncheng Mu, Tianming Wei, Chenhao Lu, Xiaofan Li, Linning Xu, Zhengrong Xue, Zhecheng Yuan, Dahua Lin, Jiangmiao Pang, and Huazhe Xu. MemoryWAM: Efficient World Action Modeling with Persistent Memory. arXiv preprint arXiv:2606.20562, 2026.