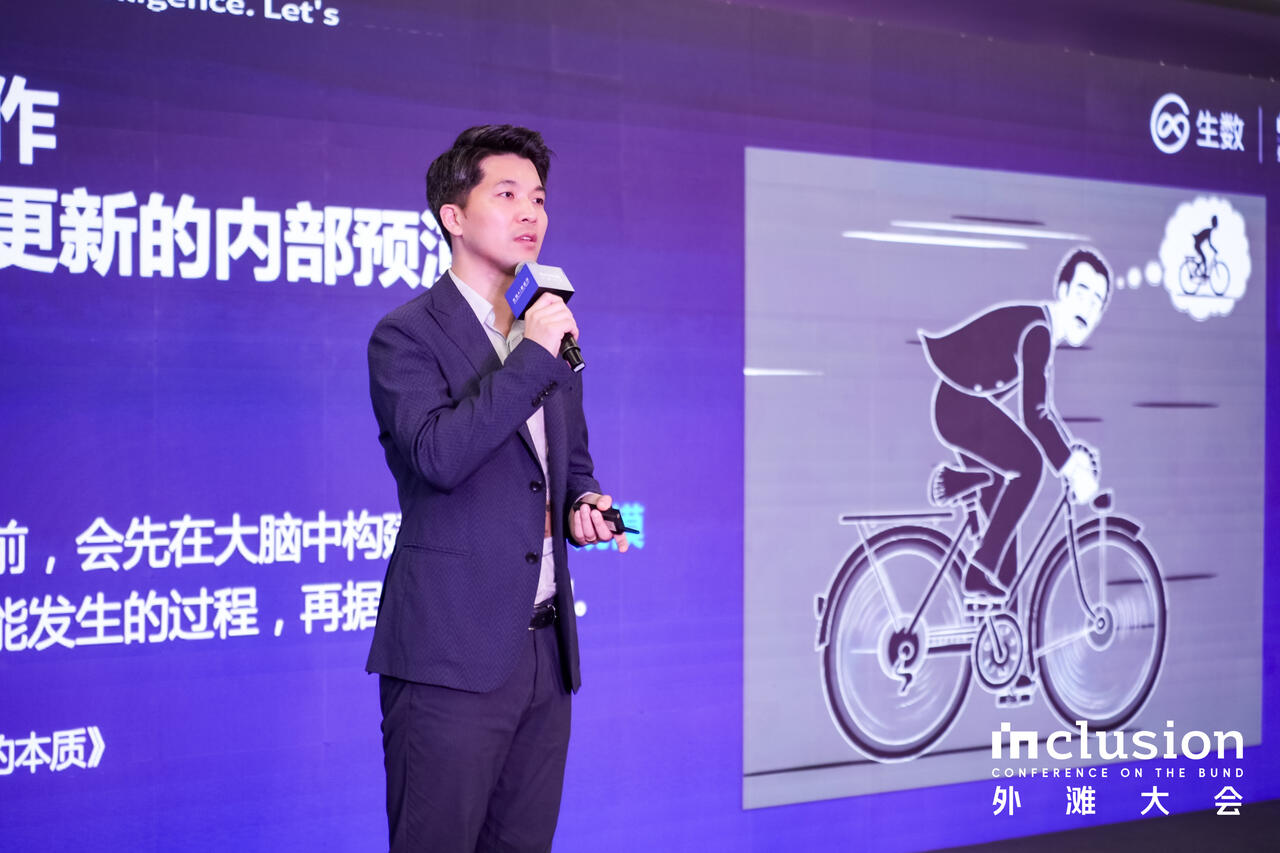
9月10日,在2026外滩大会现场,生数科技联合创始人、CEO骆怡航发表《在行动前,看见未来:从世界模型第一性原理出发》主题演讲,系统介绍生数科技对于通用世界模型(General World Model,GWM)的理解、五级发展路线,以及从视频生成、实时交互到具身行动的持续探索。
活动现场,生数科技同步发布最新研究成果 Motus2——面向机器人灵巧操作的自进化通用世界模型。9月12日起,研究团队将围绕Motus2陆续公布更多实验结果、技术细节与研究解读。
当大模型已经能够用语言回答问题、用视频生成画面,AI的下一步会走向哪里?
生数科技的判断是:AI正从屏幕上的“生成内容”,进一步走向能够理解环境、预测未来,并在真实世界中采取行动的世界智能。
而其中最关键的问题是:当AI真正进入物理世界,如何在行动前,看见未来?
世界模型的第一性原理:形成理解、想象与行动的闭环
“世界模型”正在成为AI领域最受关注的概念之一。从视频生成、环境模拟到机器人控制,不同技术路线都在尝试定义世界模型。
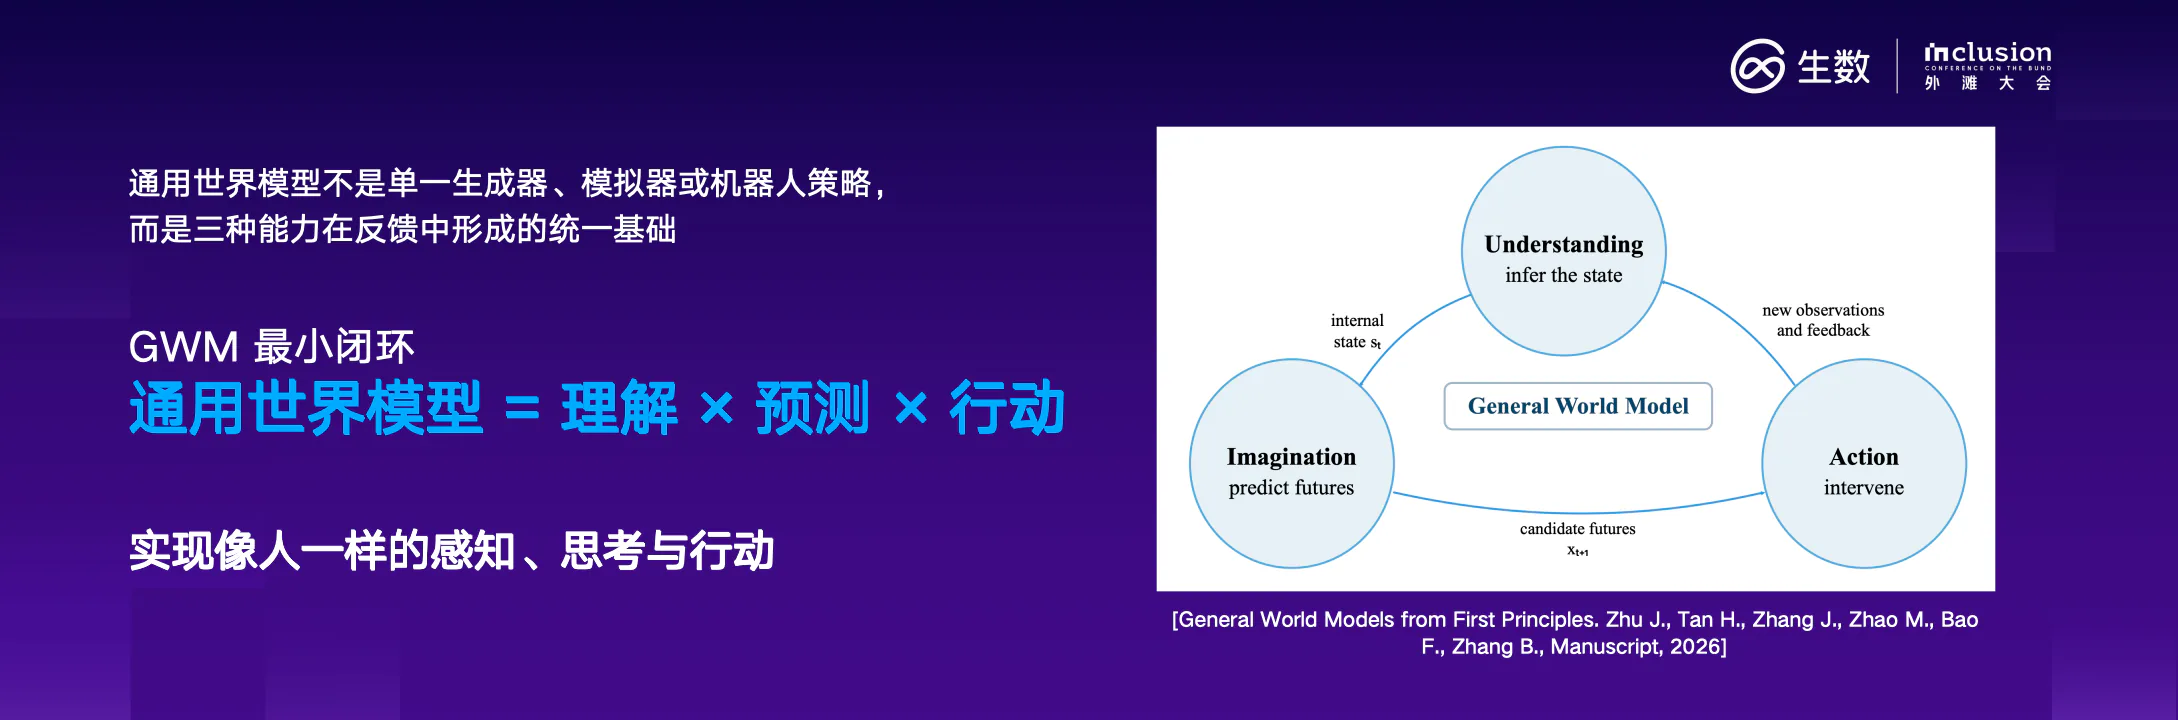
在生数科技看来,真正决定世界模型能力边界的,不是名称,而是能否形成闭环。
人类拿起一个易碎物体时,会观察环境、预判动作后果,在接触中感受变化,再根据结果调整下一步行动。真正的智能,发生在理解—想象—行动的持续循环中。
基于这一第一性原理,生数科技将通用世界模型定义为:一个能够统一理解当前世界、想象可能的未来,并通过行动改变世界的基础模型。
它不只是生成一个世界,更重要的是理解:一个行动,会让世界发生什么。
从生成到组织:一条世界智能路线,贯通数字世界与物理世界
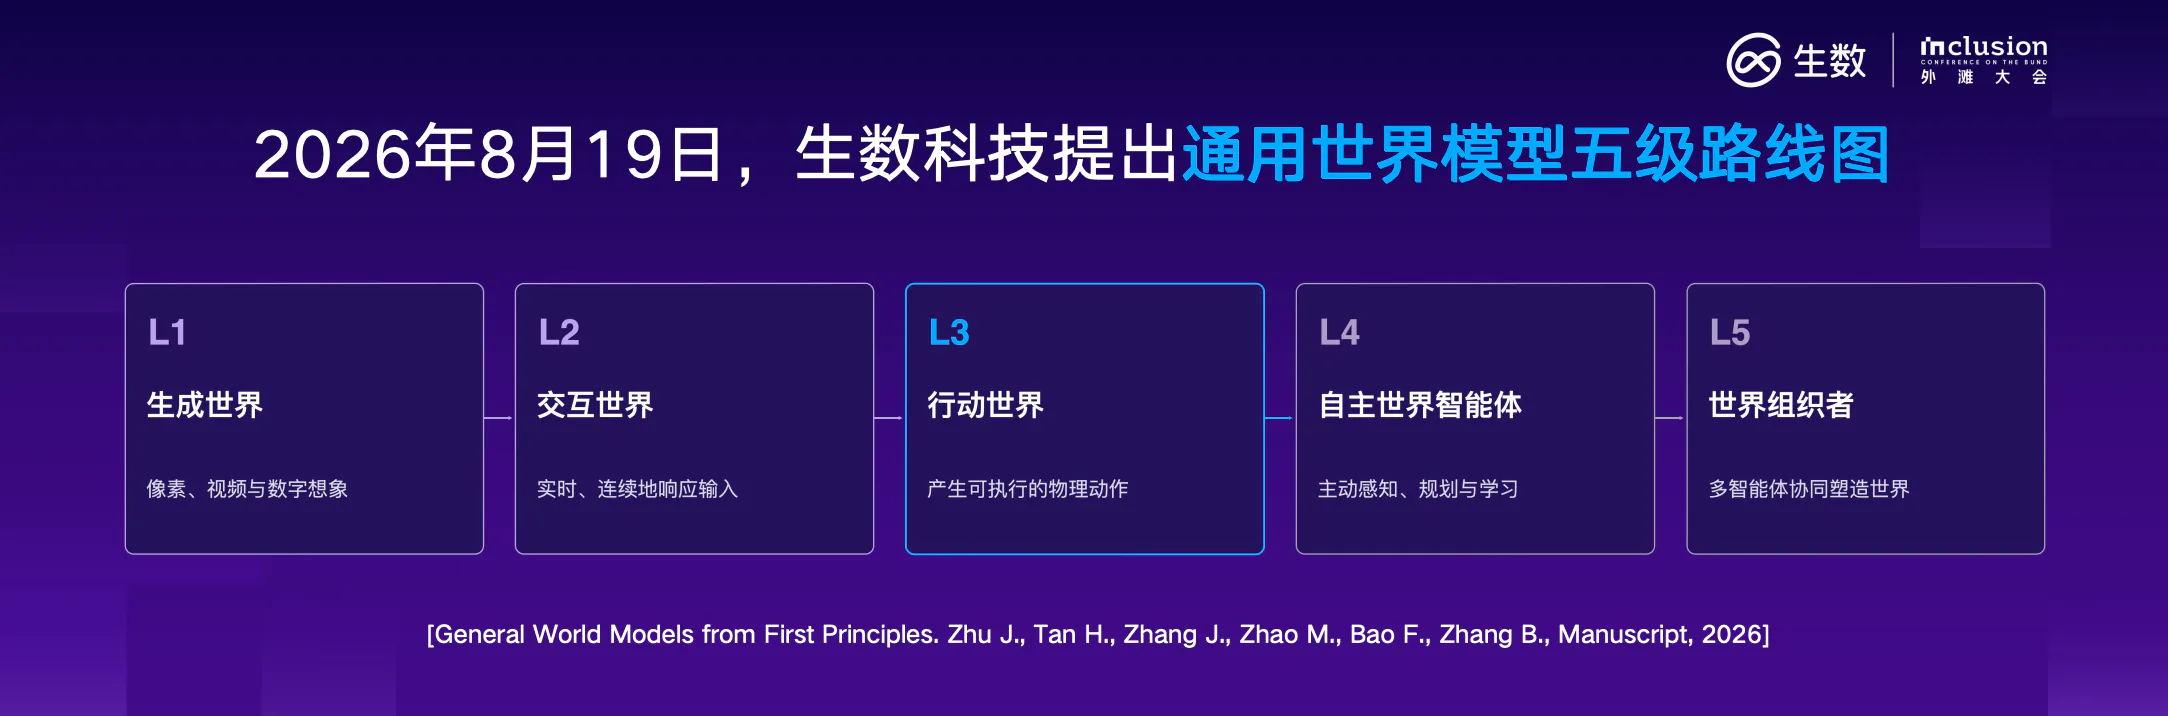
围绕这一目标,生数科技提出通用世界模型从L1到L5的五级发展路线:生成世界、与世界交互、在世界中行动、自主世界智能体、世界组织者。
这不是五个彼此割裂的产品方向,而是一条随着模型对世界理解不断深入、与世界互动持续增强,自主性逐级提升的技术路线。
过去几年,生数科技的探索也沿着这条路径展开。
在数字世界,Vidu从视频生成出发,学习物体、运动、空间关系与时间演化;随着实时交互能力加入,模型开始接收持续输入,让用户能够直接改变后续世界的演化。
进入物理世界,Motus 与 Motubrain 进一步将世界模型用于真实行动:模型不仅要理解“看到了什么”,还要判断“可以怎样做”“行动之后会怎样”,并把不同机器人、不同任务中的经验沉淀为可以迁移的世界知识。
从生成一段视频,到与持续变化的环境实时交互,再到让机器人真正承担行动的结果,表面上是产品形态的变化,背后指向的是同一个问题:模型能否把对世界的理解,变成对未来的判断。
向 L4 更进一步:Motus2 探索 RSI 的初步验证
从 L3“在世界中行动”走向 L4“自主世界智能体”,关键不只是学会更多动作,而是让模型开始具备评估和改进行动的能力:这一步做得怎么样?距离目标还有多远?下一次能不能做得更好?
这正是 Motus2 所探索的问题。
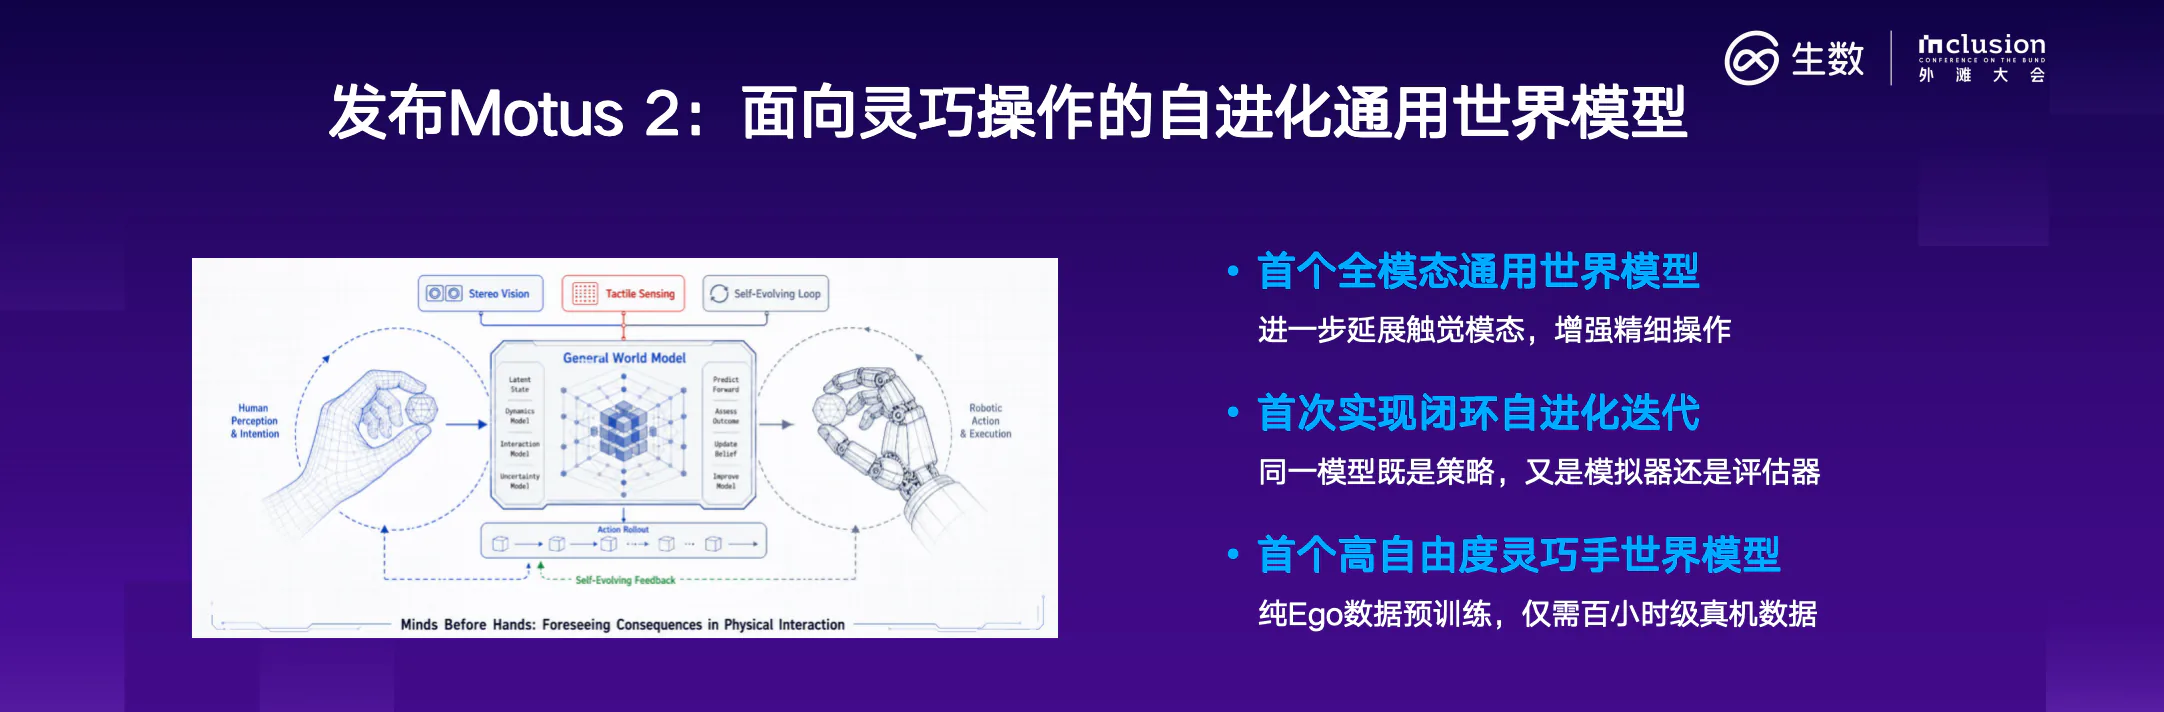
Motus2 在统一的视频—动作模型中,将策略、世界模拟与价值评估纳入同一个闭环。模型不仅能够提出动作、预测动作结果,还能评估当前行动是否更接近目标,并利用反馈进一步优化后续策略。
换句话说,世界模型不再只是回答“接下来会发生什么”,而是开始参与“怎么行动—行动得怎么样—下一步怎么改进”的完整过程。模型由此从单纯的行动生成,进一步走向行动的评估、反馈与自我改进。
这一机制呈现出类似 RSI(Recursive Self-Improvement,递归自我改进) 的初步特征:模型利用自身对世界的预测和评估结果,反过来改进行动策略。世界模型开始具备一定的自我演进能力,也是从 L3 走向 L4“自主世界智能体”的一次重要探索。
骆怡航将这种能力概括为:“心灵,然后手巧。”
“心灵”是行动前对世界的理解、推演与判断;“手巧”则是把判断落实到真实世界中的精细控制。为此,Motus2 进一步引入触觉反馈,并从大规模人类第一视角操作经验中学习,让模型形成的行动能力能够迁移到不同机器人和不同任务中。
从“会行动”,到“知道行动是否有效”,再到“根据反馈改进行动”,Motus2 正在尝试把理解、预测、行动与自我改进连接成一个更完整的闭环。
从数字世界到物理世界,AI开始承担行动的后果
当AI进入机器人、制造、服务等真实环境,它面对的不再只是“给出正确答案”,还要面对物理规律、时间约束、接触摩擦、不确定性与安全边界。
AI不仅要决定“做什么”,还要理解自己的行动会怎样改变环境,并从反馈中继续学习。
迈向L4、L5,长程记忆、物理与因果建模、在线学习、低时延部署以及安全可控等问题仍待突破。但从视频生成到实时交互,从数字世界到机器人灵巧操作,生数科技正在沿着一条连续的技术路线推进:
理解世界,想象未来,再采取行动。
在行动前,看见未来。